View Summary Pdf File Gene model: Cs_Cb2.01g051240.m01
IDENTIFICATION
- Species Name
- ARF
- Locus:
- Cs_Cb2.01g051240.m01
- Gene Model:
- Cs_Cb2.01g051240.m01
- Description:
- CsARF-01
- Family:
- ARF
- 3D Structure:
- Genome Databases:
- Tair
- Kegg
- External Resources
- GabiPD
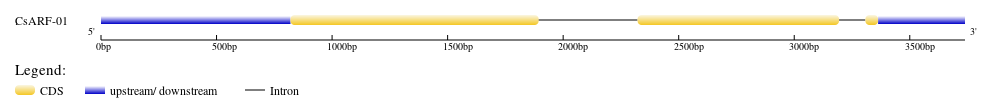
- Gene Structure:
-
- Domain Architecture:
-

- Peptide Sequences
-
>CsARF-01
MIRVMDSGREPMRRDFEKCLDPQLWHACAGPLVQMPSINSKVIYFPQGHV
EHAQGNVDFGNSRIPSHVLCRVSAIKFMADPETDEVFAKMGLTPLRDNSN
FDVEDEGYLGNNGIENSEKPKSFAKTLTQSDANNGGGFSVPRYCAETIFP
PLDFSAVPPVQNILAKDVHGETWRFRHIYRGTPRRHLLTTGWSNFVNQKK
LVAGDSIVFLRADNGDLCVGIRRAKKGIGCGHEYPYAWNPLAGNYGSQYE
NSRVVPKPGMRDARGKVKVESVVEAATLAARGQPFEVVYYPRASTPEFCV
RAPAVTAAMQIRWCSGMRFKMPFETEDSSRISWFMGTISNAQIEDPIRWP
DSPWRLLQVTWDEPDLLQNVKCVNPWLVELVSSMPMHVSPFSPPRKKMRL
PQNPDFALVSHPMPLLPTNFLNSPFHCIQDNIPAGIQGARHAQFGPYPVD
LHRNELQPGMLPLGLRKLDISDPLKNPSGGFMKNTENSENISCWLKMGHP
NQSLKANEETKTPQLLLFGQVILTEEQLSKSSSGENSSSEGNLDKTANHS
DNGSGSTVNSSDGRSPWYKFHHDGRSDQLHGQETGHCKVFIESDDVGRTL
DLSLLGSYQELYRKLGDMFGIEQVSGLFKNLLYLDATGSVKQTGEEPFSE
FLKSVRRLTILTDPRQ - CDS (Coding Sequence):
-
>CsARF-01
ATGATTAGAGTAATGGATTCTGGAAGAGAACCAATGAGGAGGGATTTTGA
AAAGTGTTTGGATCCCCAGTTATGGCACGCATGTGCTGGTCCTCTGGTTC
AAATGCCTTCCATTAACTCTAAGGTCATTTACTTTCCTCAAGGCCACGTT
GAACATGCCCAAGGGAATGTGGATTTTGGGAATTCTAGAATTCCTTCACA
CGTTCTTTGTAGGGTATCTGCGATTAAATTCATGGCGGATCCTGAAACGG
ATGAGGTTTTTGCAAAAATGGGGTTGACTCCTTTAAGGGACAACAGTAAT
TTTGATGTTGAGGATGAAGGGTATCTAGGAAACAATGGAATTGAGAATTC
TGAGAAACCCAAATCTTTTGCCAAGACTTTAACACAATCTGATGCTAACA
ATGGGGGTGGTTTTTCTGTCCCTCGTTACTGTGCTGAGACTATCTTTCCA
CCTTTGGATTTTTCAGCTGTGCCTCCTGTTCAGAACATTCTGGCTAAGGA
TGTTCATGGTGAGACTTGGAGGTTTAGACATATCTATAGAGGTACCCCTC
GCCGGCACCTTTTGACTACCGGTTGGAGTAATTTTGTGAACCAAAAGAAG
CTTGTTGCTGGTGATTCAATTGTGTTTTTGAGGGCTGATAATGGTGATCT
CTGTGTTGGAATAAGGAGGGCTAAGAAGGGGATTGGTTGTGGACATGAGT
ACCCTTATGCTTGGAATCCTTTAGCTGGAAACTATGGTTCTCAATATGAG
AATAGTAGAGTGGTGCCAAAACCAGGTATGAGAGATGCAAGGGGAAAAGT
GAAAGTTGAATCTGTTGTTGAAGCTGCAACTCTTGCAGCTAGAGGACAAC
CATTTGAAGTAGTGTACTATCCGCGGGCAAGCACCCCGGAGTTTTGTGTT
AGAGCCCCGGCTGTAACGGCTGCAATGCAAATCAGGTGGTGCTCAGGGAT
GCGGTTCAAGATGCCCTTTGAGACTGAGGATTCTTCTCGAATAAGCTGGT
TCATGGGTACTATTTCTAATGCCCAGATTGAGGATCCAATCCGTTGGCCT
GATTCTCCTTGGCGTCTTTTACAGGTGACATGGGACGAACCAGATTTACT
ACAGAATGTGAAATGTGTTAATCCGTGGTTGGTCGAACTGGTCTCAAGCA
TGCCCATGCATGTCTCTCCATTCTCACCACCTAGAAAGAAGATGCGGCTT
CCACAGAACCCAGATTTTGCTCTAGTTAGCCATCCTATGCCATTACTTCC
CACCAACTTCCTCAACAGCCCCTTCCATTGTATTCAAGACAACATTCCTG
CAGGCATACAGGGAGCCAGGCATGCTCAATTTGGGCCATATCCAGTGGAC
CTCCACCGAAATGAACTGCAGCCGGGAATGCTTCCACTTGGTCTTCGGAA
GTTGGATATCTCTGATCCTCTTAAAAATCCAAGTGGTGGTTTCATGAAAA
ACACCGAGAACAGTGAGAATATTTCTTGCTGGCTAAAAATGGGGCATCCC
AATCAAAGTTTGAAGGCAAATGAGGAAACAAAGACACCTCAGTTGTTATT
GTTTGGACAGGTTATACTGACTGAAGAACAACTCTCAAAGAGTTCCTCTG
GTGAAAACAGTTCATCTGAGGGGAATTTAGACAAGACAGCAAATCATTCT
GATAATGGCTCTGGTTCAACAGTGAACTCATCTGATGGAAGGTCACCCTG
GTACAAGTTTCATCATGATGGGAGAAGTGATCAACTTCATGGTCAGGAGA
CTGGTCACTGCAAGGTGTTCATTGAATCGGATGATGTGGGAAGAACCCTT
GATCTCTCTCTTCTTGGTTCATATCAAGAACTGTACAGAAAGCTAGGTGA
CATGTTTGGTATAGAACAGGTTTCAGGGCTTTTTAAAAATCTTCTATACC
TGGACGCAACAGGTTCTGTTAAACAAACCGGAGAGGAACCCTTCAGTGAG
TTTTTGAAGTCAGTAAGAAGGCTAACCATCCTCACGGATCCCAGGCAGTG
A - Nucleotide:
-
>CsARF-01
CGATCCGAAAACAAGGAAGGAAGAAAAAAAATCAGGCAAGTCTGTGCTTA
AATTAAATTTAAATTAATTTATAATTAATTATTAAAAATGTAATTATAAT
TTGTTTATTTTGTTAATGCATATAATATAAAGAACCCTTTCTTTCTTGCT
CACTATCACACACAGACAGTCTGGTCGGCAACGAAGCTTCACTGATTTAT
ATCGTTTTTAGGGTGTGTGAGTGTGTCGGGTACTGTGATTATACATACAA
AAATTAATATTTTTATATATATCATCAATATATACGTATGTATTTGTTCT
CACATATATATATAGGCAAACTTCTCATTTCACACTTTGAACCTACTCTT
CTTCTTCACACACCCGTTTCTTTACCAGAAAGATTCTCCAGGCTTTGATT
TTAATTTTCAGGGAATTTTGATAAATTCCTGTCCTGGTAGAATTTTGGTG
TCCTTTTCTCTGAATTTACGGTCATGTTTCCTGAAAATGCTTCTGTTTGT
TTAGACTAGAAGAGAAGAGAAGAGAAGAGAAGAGAAGACCCTTTTGTTGG
TGTATGTGTTGAAGCTTTCTGGGTACTCTAGTTATTCAGTATTCGATTTT
TTGAGTTTAGAGGTAAACATTCATATATTTTGTTTTTCGAATTTTGTTTA
GTGGGTTTTGGTTGGTTTTCTGAATATTAGTTTGGAATATTTTAGTAGTT
ATTATTGATTGCCCTTTTATTGCGAATTAAATATGGGTTTTGTCTTTATT
TTCTGTTATGATTTCTGACATAGATTTTTGGTATGATAACAGTGTCGAGG
CCTTTTGTATTTAGCTAAAGATGATTAGAGTAATGGATTCTGGAAGAGAA
CCAATGAGGAGGGATTTTGAAAAGTGTTTGGATCCCCAGTTATGGCACGC
ATGTGCTGGTCCTCTGGTTCAAATGCCTTCCATTAACTCTAAGGTCATTT
ACTTTCCTCAAGGCCACGTTGAACATGCCCAAGGGAATGTGGATTTTGGG
AATTCTAGAATTCCTTCACACGTTCTTTGTAGGGTATCTGCGATTAAATT
CATGGCGGATCCTGAAACGGATGAGGTTTTTGCAAAAATGGGGTTGACTC
CTTTAAGGGACAACAGTAATTTTGATGTTGAGGATGAAGGGTATCTAGGA
AACAATGGAATTGAGAATTCTGAGAAACCCAAATCTTTTGCCAAGACTTT
AACACAATCTGATGCTAACAATGGGGGTGGTTTTTCTGTCCCTCGTTACT
GTGCTGAGACTATCTTTCCACCTTTGGATTTTTCAGCTGTGCCTCCTGTT
CAGAACATTCTGGCTAAGGATGTTCATGGTGAGACTTGGAGGTTTAGACA
TATCTATAGAGGTACCCCTCGCCGGCACCTTTTGACTACCGGTTGGAGTA
ATTTTGTGAACCAAAAGAAGCTTGTTGCTGGTGATTCAATTGTGTTTTTG
AGGGCTGATAATGGTGATCTCTGTGTTGGAATAAGGAGGGCTAAGAAGGG
GATTGGTTGTGGACATGAGTACCCTTATGCTTGGAATCCTTTAGCTGGAA
ACTATGGTTCTCAATATGAGAATAGTAGAGTGGTGCCAAAACCAGGTATG
AGAGATGCAAGGGGAAAAGTGAAAGTTGAATCTGTTGTTGAAGCTGCAAC
TCTTGCAGCTAGAGGACAACCATTTGAAGTAGTGTACTATCCGCGGGCAA
GCACCCCGGAGTTTTGTGTTAGAGCCCCGGCTGTAACGGCTGCAATGCAA
ATCAGGTGGTGCTCAGGGATGCGGTTCAAGATGCCCTTTGAGACTGAGGA
TTCTTCTCGAATAAGCTGGTTCATGGGTACTATTTCTAATGCCCAGATTG
AGGATCCAATCCGTTGGCCTGATTCTCCTTGGCGTCTTTTACAGGTTAGT
AATTTTATTTCATTTCTGTTAGGACTGGACTATGTTGTGCCTCTTTTCTT
GATGTTTTTGCTTGGTAGTGTTGTGTGGTACAATGGATGTTGTCCTTTGG
ATACATGTGTAAAGTTCAGTCTTAGAAAGATGTTGTCCCTAATTTAGATC
AGTGAACTTTTGAAACTAATATGAAGATGACTTTTTTCAACTCTATTTAA
AACAAATGACAGTTATTAGCAAAGGACAGTTGAATTTTGTATCTGCTTTT
ATATCATCTTAGTAGCTTATCATTTCAAGCAATCATTAGGCATTAAGTAG
GTCTGTAGTTTTGGCATTTTGGACATATTCTAGCAGTAGTATTACTTCTA
GTAGACAGGTTTCAATTGGGTGATTTTCCTGGTTTGAGTTACTGAAAGAT
CATTTTAATACATCTTTTTTAGGTGACATGGGACGAACCAGATTTACTAC
AGAATGTGAAATGTGTTAATCCGTGGTTGGTCGAACTGGTCTCAAGCATG
CCCATGCATGTCTCTCCATTCTCACCACCTAGAAAGAAGATGCGGCTTCC
ACAGAACCCAGATTTTGCTCTAGTTAGCCATCCTATGCCATTACTTCCCA
CCAACTTCCTCAACAGCCCCTTCCATTGTATTCAAGACAACATTCCTGCA
GGCATACAGGGAGCCAGGCATGCTCAATTTGGGCCATATCCAGTGGACCT
CCACCGAAATGAACTGCAGCCGGGAATGCTTCCACTTGGTCTTCGGAAGT
TGGATATCTCTGATCCTCTTAAAAATCCAAGTGGTGGTTTCATGAAAAAC
ACCGAGAACAGTGAGAATATTTCTTGCTGGCTAAAAATGGGGCATCCCAA
TCAAAGTTTGAAGGCAAATGAGGAAACAAAGACACCTCAGTTGTTATTGT
TTGGACAGGTTATACTGACTGAAGAACAACTCTCAAAGAGTTCCTCTGGT
GAAAACAGTTCATCTGAGGGGAATTTAGACAAGACAGCAAATCATTCTGA
TAATGGCTCTGGTTCAACAGTGAACTCATCTGATGGAAGGTCACCCTGGT
ACAAGTTTCATCATGATGGGAGAAGTGATCAACTTCATGGTCAGGAGACT
GGTCACTGCAAGGTGTTCATTGAATCGGATGATGTGGGAAGAACCCTTGA
TCTCTCTCTTCTTGGTTCATATCAAGAACTGTACAGAAAGCTAGGTGACA
TGTTTGGTATAGAACAGGTTTCAGGGCTTTTTAAAAATCTTCTATACCTG
GACGCAACAGGTTCTGTTAAACAAACCGGAGAGGAACCCTTCAGGTATTA
TCTTATTCATAACTTATTAGTATATGATCTTCTTTCAGATTTACATTATT
GAGTCCTCATTGTGATGGTTCTAATAATTTTGCATTTGTGTTGTTTCTTT
TGTGGCAGTGAGTTTTTGAAGTCAGTAAGAAGGCTAACCATCCTCACGGA
TCCCAGGCAGTGAAACTTTAGGAACATATGAGAAACTCTCCTTTGAATTG
TACAGCTGAAATGACTTAAAAAGTCTTTATAATTTCATGTTTTTTTTTTA
TTCCACAACAAAAATTTGTGGGATAAGATTGACTTGTTTCATTTTGGATA
TTGATGATTTAATTTCCCAGAAAACAAAGTTCATATGTTTTTTCTTTAAA
CAACTTCCTGTCTCTAATGTTTTGTGTTATGTAAATACTTTATGTTCTGT
TAACACAAAAAGAACCAAACTAGCCTTGTAATTTAACTTCATGTTTCTCA
TTCTTTTCACTTTGCTTTATTCACACGCTTTTTATAGTAACATTATTATA
TTGTCAATAAAACTATGATGGCAAATCAAGTCTTATCAC