View Summary Pdf File Gene model: Cs_Cb2.08g363660.m01
IDENTIFICATION
- Species Name
- AP2
- Locus:
- Cs_Cb2.08g363660.m01
- Gene Model:
- Cs_Cb2.08g363660.m01
- Description:
- CsAP2-19
- Family:
- AP2
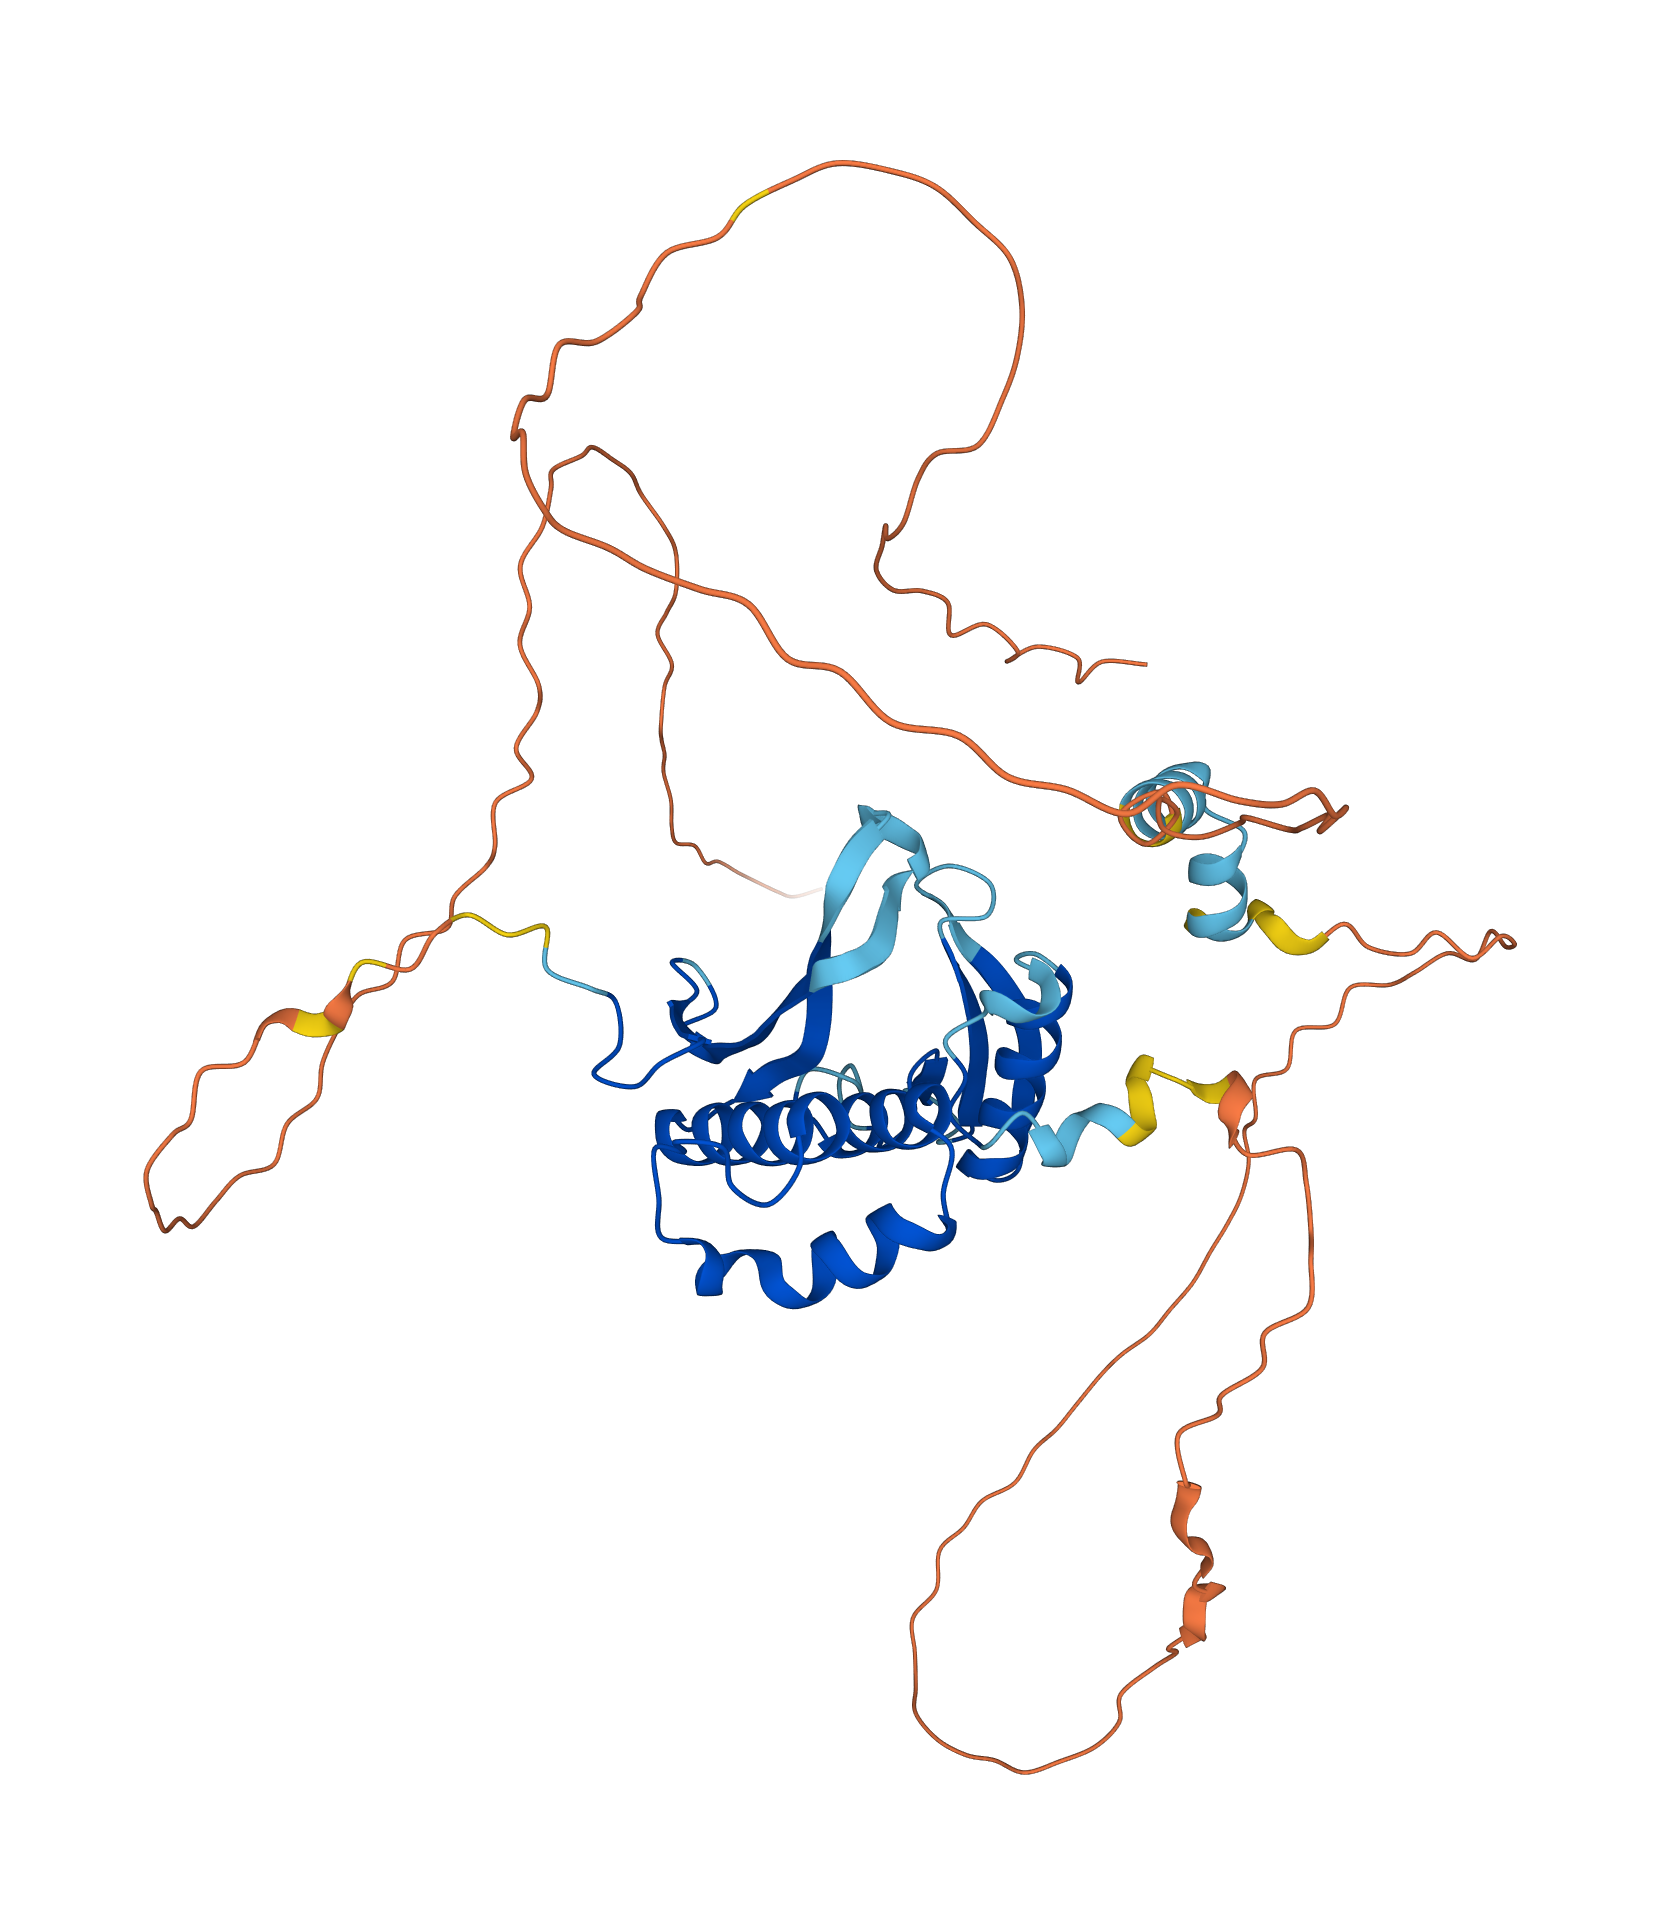
- 3D Structure:
- CsAP2-19
- Genome Databases:
- Tair
- Kegg
- External Resources
- GabiPD
- Gene Structure:
-

- Domain Architecture:
-

- Peptide Sequences
-
>CsAP2-19
MKLMMVKSEDNQNSTRRRRVSMVADSEAQAALRCVKRRKRDIPTDQVISC
DDNKQGTQADDQAPPATTTTVKRSSKYRGVSRHRWTGRYEAHLWDKLSWN
VTQKKKGKQVYLGAYDEEESAARAYDLAALKYWGTSTFTNFPISDYEKEI
EIMVTVTKEEYLATLRRKSSGFSRGVSKYRGVARHHHNGRWEARIGRVFG
NKYLYLGTYSTQEEAARAYDIAAIEYRGINAVTNFDLSTYIRWLKPEAAT
NPVSGCESLPEVITEPQTLQSTANYNTPTDQDYMKSNNDYLNKYSLTPPK
QQLVCQTKSPLIGSTMTRSKSSPSALGLLLQSSMFRELVEKNSNVSEYET
DGDEPKNQLQGGCSSDDDEYGGFFFGGISDIPFVCDPNSSDVIQIEQEKG
IHFVL - CDS (Coding Sequence):
-
>CsAP2-19
ATGAAACTGATGATGGTAAAGAGTGAGGATAATCAGAATAGTACTAGGAG
GCGTCGGGTTAGTATGGTCGCCGACAGTGAAGCTCAAGCGGCGTTAAGGT
GTGTTAAGAGACGAAAAAGAGATATTCCAACCGATCAAGTAATTAGTTGT
GATGATAACAAACAGGGGACTCAAGCTGATGATCAAGCTCCTCCTGCCAC
CACTACTACTGTCAAAAGAAGCTCGAAATATCGGGGTGTTAGTAGACATA
GATGGACGGGTCGGTATGAAGCTCATTTGTGGGATAAGCTCTCTTGGAAT
GTAACACAGAAGAAGAAAGGAAAGCAAGTTTACCTTGGAGCTTATGATGA
AGAAGAATCTGCAGCAAGAGCATATGATTTAGCTGCACTTAAGTACTGGG
GGACATCTACTTTCACCAATTTCCCTATATCAGATTATGAGAAGGAGATT
GAGATAATGGTAACTGTGACCAAAGAGGAGTATTTAGCCACTTTAAGAAG
AAAGAGCAGTGGTTTTTCAAGAGGTGTATCCAAGTACAGGGGAGTCGCAA
GGCACCATCATAATGGTAGATGGGAAGCAAGAATAGGAAGAGTTTTTGGA
AACAAGTACCTGTATCTTGGCACATACAGTACCCAAGAAGAAGCTGCTCG
CGCTTATGACATAGCAGCCATAGAGTACAGAGGAATCAATGCAGTGACAA
ACTTCGATTTGAGCACTTACATAAGATGGTTGAAGCCCGAAGCAGCCACC
AACCCGGTTAGCGGTTGTGAATCTTTACCCGAGGTTATAACAGAACCTCA
AACACTCCAATCCACAGCCAACTACAATACACCAACAGATCAAGATTACA
TGAAGTCTAATAATGATTACTTGAATAAGTACTCTCTAACTCCACCGAAA
CAGCAGTTAGTTTGCCAAACTAAAAGCCCTCTAATTGGCAGTACTATGAC
TCGCAGCAAGTCTTCTCCTTCTGCTCTCGGCCTCCTTCTTCAATCTTCGA
TGTTTAGAGAATTGGTGGAGAAGAACTCAAATGTCTCAGAGTACGAAACA
GATGGGGATGAGCCGAAGAACCAGCTGCAGGGTGGCTGCAGCAGTGATGA
TGATGAGTATGGCGGGTTCTTCTTTGGTGGAATCAGTGATATCCCGTTTG
TATGTGATCCCAACTCGTCGGATGTCATACAGATAGAACAAGAAAAAGGA
ATTCACTTTGTTTTGTGA - Nucleotide:
-
>CsAP2-19
ATGAAACTGATGATGGTAAAGAGTGAGGATAATCAGAATAGTACTAGGAG
GCGTCGGGTTAGTATGGTCGCCGACAGTGAAGCTCAAGCGGCGTTAAGGT
GTGTTAAGAGACGAAAAAGAGATATTCCAACCGATCAAGTAATTAGTTGT
GATGATAACAAACAGGGGACTCAAGCTGATGATCAAGCTCCTCCTGCCAC
CACTACTACTGTCAAAAGAAGCTCGAAATATCGGGGTGTTAGTAGACATA
GATGGACGGGTCGGTATGAAGCTCATTTGTGGGATAAGCTCTCTTGGAAT
GTAACACAGAAGAAGAAAGGAAAGCAAGGTAAAGATGAGTTGTAATATGG
TTTAGTTTACCTTCTTTGTTGTTACTTCAACTATTTGATTTTCTCAATTG
CTTACTGACTAGTGTTTGTTTACTTGTTGAAAATCTTTGTCCCAATGCTT
TGATGTTATGTCTTCGGCTCAACAGTTTACCTTGGTAAGTAATAAACAGT
ATTTAATGTTTCAGTAGAAAGTTCAGAGCTTTTTGTTATCAGATACTCAA
GGCCAGCCCTCGAAATTGTGAAAAATTAAAATATTAAATAATAAAAAAAT
ACGACAAATAAAGAGATTAAAGGATCAATTCCAAACATTTACTGAAATTT
ATATAGGGCCTTAAAATTTAATTTTATTTTAATTCTTATATACTTTAGGA
CCGACCTGATGAGACTTAGTGTTCTTGTTTATACTTCAGGAGCTTATGAT
GAAGAAGAATCTGCAGCAAGAGCATATGATTTAGCTGCACTTAAGTACTG
GGGGACATCTACTTTCACCAATTTCCCTGTATGGATATGGATTTTTTTTT
TTTTTTTTATGTTCATTATGTGTTATCTAAATTTATGAACATAGTAAATT
AATGAAAATCTTTGGTTGGTGGTGATACTGTTTTAACAGATATCAGATTA
TGAGAAGGAGATTGAGATAATGGTAACTGTGACCAAAGAGGAGTATTTAG
CCACTTTAAGAAGGTACTTGTTTGTATAAAGGTTATCTTGTTACTCAAAT
AACTCAAATAGTTTTGGCCATTTTTCTTACTAAAAAGTTACTTCTTTCTG
GTGTTGCAGAAAGAGCAGTGGTTTTTCAAGAGGTGTATCCAAGTACAGGG
GAGTCGCAAGGTGATTATCATGACTCGATGCTATTTAATAAATGATAAAA
ATTATTTTGGACTGTTTTTTTTTTTCAAAAATTACTGATCAGATTCTGTT
TTGTTAAATTACAAATTGAATTGTGTATTTTCAGAAATGGTACAAAAAAT
ACTGTGAACTCAATTTTGATCATTATTTTTTAATATAACTAAGCTAAAGC
CAAATTTCCCTGAACAGATACAAAAAGATGTAACCAGTTCGGGCTTAGGG
TATTATTTTGTACAATTTTAAAAATATAGGGTTTGAATTGTCATGTAACA
AAATAAAAAGTCTGATTAATAACTTCTGTAAAACACAGGATCCAAAATAG
AATCAACCATATAATAAAACAAATTCTCAAATATATTTTTGATAATTGTT
GTATGCAGGCACCATCATAATGGTAGATGAATCAACCATATAATAAAACA
AATTCTCAAATATATTTTTGATAATTGTTGTATGCAGGCACCATCATAAT
GGTAGATGGGAAGCAAGAATAGGAAGAGTTTTTGGAAACAAGTACCTGTA
TCTTGGCACATACAGTAAGTTGTTGTACAAATCTTCATACTGTATATCAT
ACTATCTAATATGAAATATTTTGTTAAGTGCCTTAGCTCTTGCTGATCAT
AGGTACCCAAGAAGAAGCTGCTCGCGCTTATGACATAGCAGCCATAGAGT
ACAGAGGAATCAATGCAGTGACAAACTTCGATTTGAGCACTTACATAAGA
TGGTTGAAGCCCGAAGCAGCCACCAACCCGGTTAGCGGTTGTGAATCTTT
ACCCGAGGTTATAACAGAACCTCAAACACTCCAATCCACAGCCAACTACA
ATACACCAACAGATCAAGATTACATGAAGTCTAATAATGATTACTTGAAT
AAGTACTCTCTAACTCCACCGAAACAGCAGTTAGTTTGCCAAACTAAAAG
CCCTCTAATTGGCAGTACTATGACTCGCAGCAAGTCTTCTCCTTCTGCTC
TCGGCCTCCTTCTTCAATCTTCGATGTTTAGAGAATTGGTGGAGAAGAAC
TCAAATGTCTCAGAGTACGAAACAGATGGGGATGAGCCGAAGAACCAGCT
GCAGGGTGGCTGCAGCAGTGATGATGATGAGTATGGCGGGTTCTTCTTTG
GTGGAATCAGTGATATCCCGTTTGTATGTGATCCCAACTCGTCGGATGTC
ATACAGATAGAACAAGAAAAAGGAATTCACTTTGTTTTGTGAAAGATCAT
TCATAGCATCTTTGGCATTATTGTGAAGTATTCAGGTTTTCATTTTCAGA
AGCAAAAAACAGAACAGAAAATAATTTTCATCACTTGTAAATAAGAGTTT
GGTCCATCAAAAGTCAAAACTAGTAATGCAGATGTTAATAAGGCTTACTT
AAATTATGTAGACTTTTTGATTCAAATGGAAAATATACTGTCTCATAACT
TCACCTCGTACTGTTGTCTTTAGAGTAGGAGAAGGTTACAAAAAGAAGAA
CAGATGGGATAAAATAGCCTTTTTTTTATAAGGGTTTCCTTATCACACGG
CGAGCAATATATACTTAAGATTAAGGTATAGCACACCACATAGTAATTTA
AACCAATATCGTTTATTAAATTAAAATATATAAGATTCAATATTAAATTA
TACGAAAGTATGACACTTTATATGGTTTTGGACACCATTACCGCTCCTTA
GCGTTATTCTATCCTTAATAAGTTGGGAGAGTAAACACAAGAATAGTGTC
TTCAATTTGGTGCACTTGATGTTTCCCTTACTGATATCGATTTAGTTGTT
CTGTTTTTTAGGCTTTCTAATTCACTAACTTTTACCTCTTCAACAATGTT
GAGTTGTCTATCTTTTGGGAAGCAATGTCTGGTAATGT