View Summary Pdf File Gene model: Cs_Cb2.01g090120.m01
IDENTIFICATION
- Species Name
- CPP
- Locus:
- Cs_Cb2.01g090120.m01
- Gene Model:
- Cs_Cb2.01g090120.m01
- Description:
- CsCPP-01
- Family:
- CPP
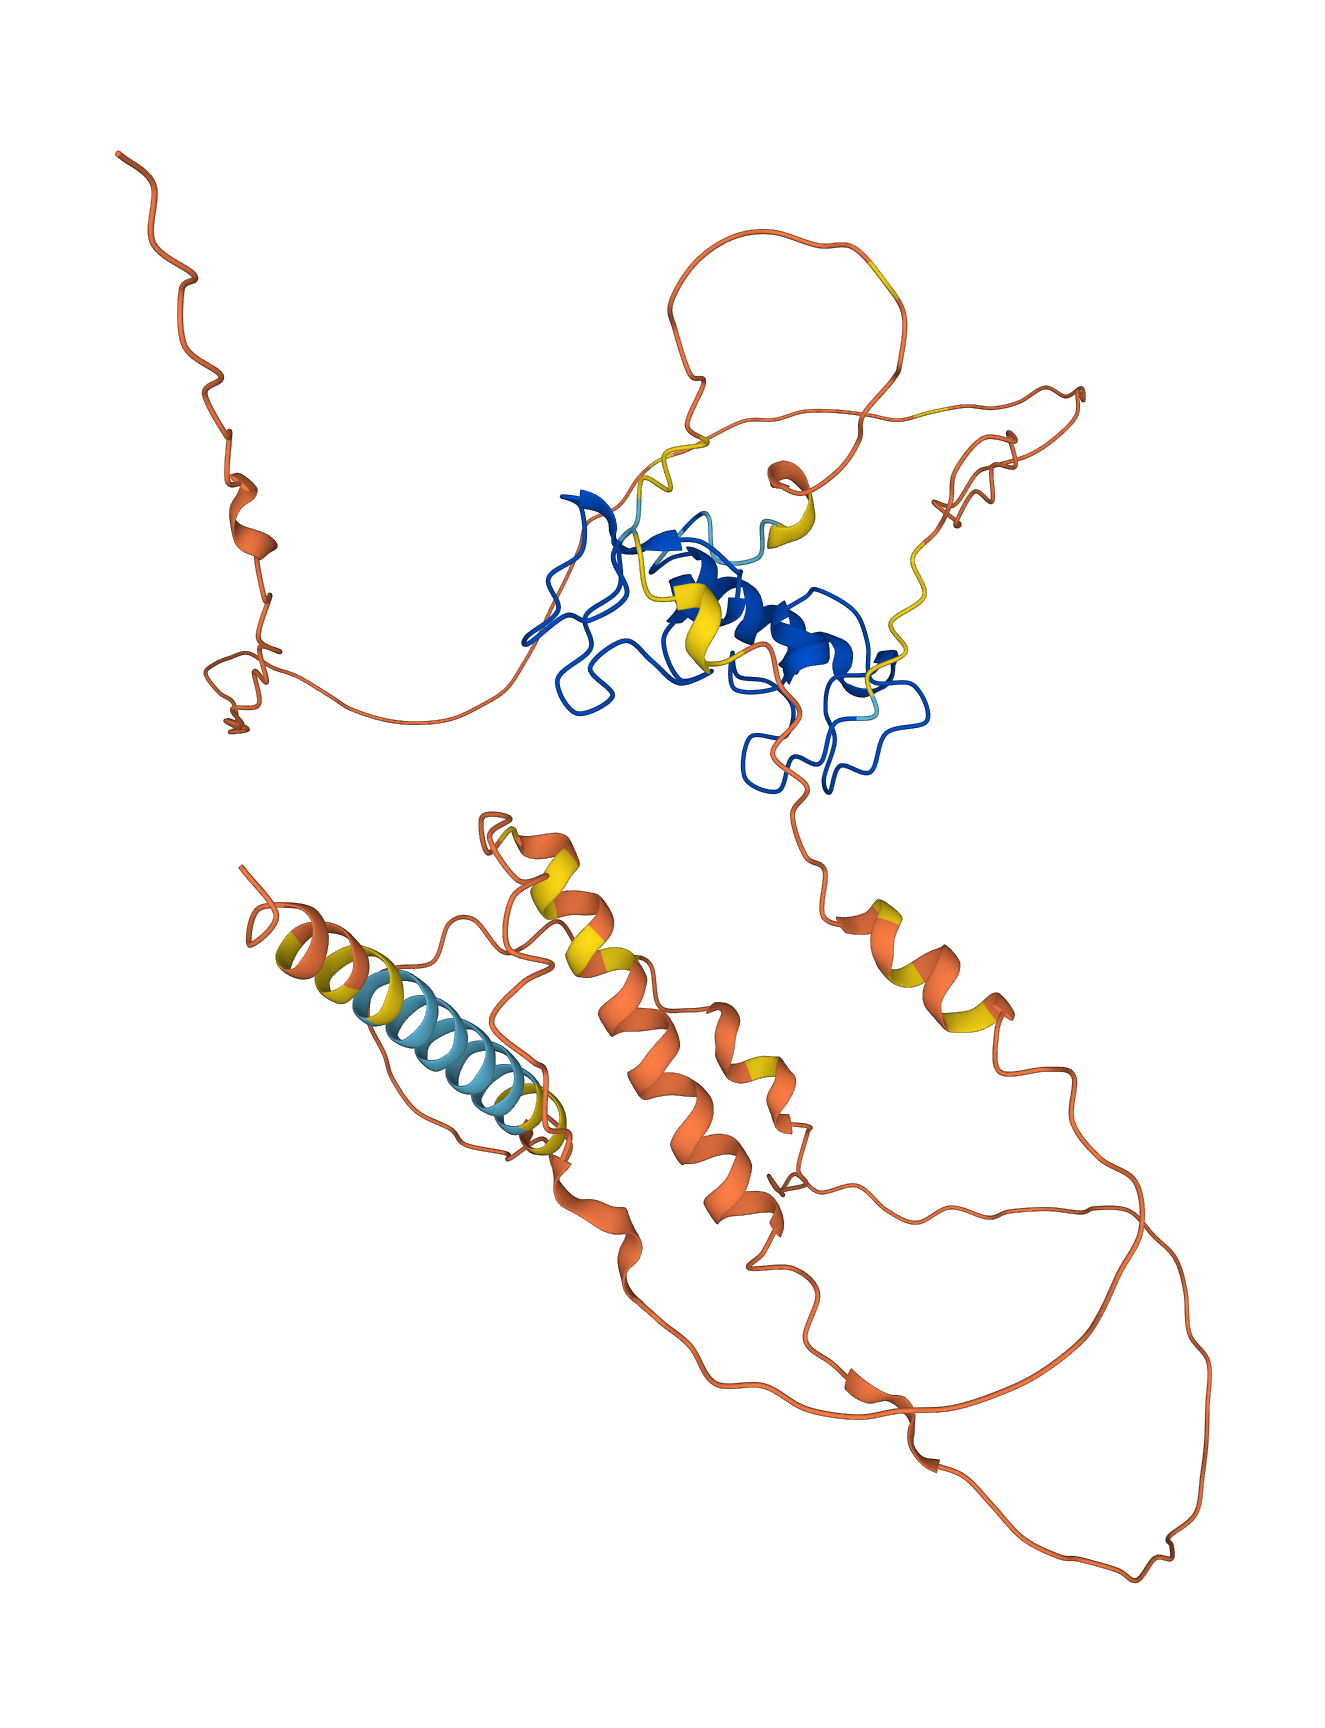
- 3D Structure:
- CsCPP-01
- Genome Databases:
- Tair
- Kegg
- External Resources
- GabiPD
- Gene Structure:
-
- Domain Architecture:
-
- Peptide Sequences
-
>CsCPP-01
MEVPGKNQMRRSRGRYRRSRFRAKNLVKQLDFSMSGSLSLDPSSSSLNYL
KSPAKPNLELYLSPPIEPFTENIESSAVQPQAQIGIEEDNGPQEHQGQCR
CKLTKCLKMYCECFSSGFYCNGCNCIDCHNNIKNEPARTAAVESILERNQ
NAFRSKTANSLHVTPDIKVQKKGTTSVRKQQKGCHCKKTFCLKKYCECFQ
AKILCSEHCKCLDCKNVDGFEESILSPQKHYDAETSVKRARETSSSISTK
KEGQGSPLVTFRAPPAFSANALECRSWQASITTDSIKRICSNMFVGAHAD
RILTAVNSFTSVKPDKPNVGEVVPDDHLNDYGVNIVNTKLPKTANVNGQE
GMVLSPTAEALKCDEKVTMLREATASFDGNYKRIPNAKPYMEQERIILTN
FRDFLKKIISVNTNSTGTSTGIQCDHVGT - CDS (Coding Sequence):
-
>CsCPP-01
ATGGAAGTCCCCGGCAAAAATCAGATGAGACGATCAAGAGGCCGCTATCG
GCGTTCCAGATTTCGCGCCAAAAATCTGGTTAAGCAGTTAGATTTTTCAA
TGTCTGGCAGCTTATCTTTGGATCCTAGTTCATCTTCGCTTAATTACTTG
AAGTCGCCTGCGAAACCTAACTTGGAGCTTTATTTGTCACCTCCAATCGA
ACCATTTACAGAAAATATAGAGTCCTCAGCAGTACAACCTCAAGCTCAAA
TTGGAATAGAAGAAGATAATGGCCCTCAAGAGCATCAAGGACAATGTCGT
TGCAAGCTAACTAAGTGCTTAAAAATGTACTGTGAATGCTTTTCTTCTGG
ATTCTACTGCAATGGGTGCAATTGTATTGATTGTCACAATAACATCAAAA
ATGAGCCTGCGAGGACTGCAGCTGTTGAAAGTATTTTAGAACGAAACCAA
AATGCTTTCAGGTCAAAAACCGCTAACAGCTTGCATGTAACCCCAGATAT
TAAGGTTCAGAAAAAGGGCACTACATCCGTAAGAAAACAACAAAAGGGGT
GCCATTGTAAGAAAACATTTTGCCTAAAGAAATATTGCGAGTGCTTCCAA
GCTAAGATCCTCTGTTCTGAACATTGTAAATGCTTGGACTGCAAGAACGT
AGACGGATTTGAGGAGAGTATACTATCACCTCAGAAACATTATGACGCAG
AAACCTCTGTCAAGAGGGCCAGGGAGACATCTTCTTCAATATCAACTAAA
AAAGAAGGCCAGGGGAGTCCTCTTGTAACTTTTAGGGCACCGCCTGCCTT
TTCTGCCAATGCTCTCGAATGCAGATCATGGCAAGCAAGTATAACTACAG
ATTCCATTAAGCGCATTTGCTCAAATATGTTTGTAGGGGCTCATGCTGAT
AGGATACTTACTGCAGTCAATAGTTTCACTTCAGTGAAGCCAGATAAACC
AAATGTAGGGGAAGTGGTTCCAGATGACCATTTGAATGATTATGGAGTAA
ACATAGTCAATACAAAGTTACCCAAAACTGCAAATGTCAATGGACAAGAA
GGGATGGTGTTATCTCCTACAGCAGAGGCGTTAAAATGTGATGAGAAAGT
TACCATGTTGAGAGAAGCTACTGCGTCCTTTGATGGAAATTATAAGCGGA
TCCCTAATGCAAAGCCCTATATGGAGCAGGAAAGGATTATCTTGACAAAC
TTCCGGGATTTTCTTAAGAAGATTATCTCTGTGAACACTAATTCAACTGG
AACTTCTACAGGGATTCAATGTGACCATGTAGGTACTTGA - Nucleotide:
-
>CsCPP-01
GATATTGACTGGCTTTCCGGAAAGTGAAAAAGCTATCGTGATTCAAATTC
CATGGAATAATGATTTTTTTTTTCTTTCCTTGACTATATTTGTTTCGGTT
TGCATTTGAAGTGTGATCGATCAGATCGACAATGGAAGTCCCCGGCAAAA
ATCAGATGAGACGATCAAGAGGCCGCTATCGGCGTTCCAGATTTCGCGCC
AAAAATCTGGTTAAGCAGTTAGATTTTTCAATGTCTGGCAGCTTATCTTT
GGATCCTAGTTCATCTTCGCTTAATTACTTGAAGTCGCCTGCGAAACCTA
ACTTGGAGCTTTATTTGTCACCTCCAATCGAACCATTTACAGAGTGAGTT
CTCTGCAATTCTAGGTTCTTGATATAAGAGCTACGATATTTTCTTTCTGT
TTTCACGAGAAAATACCGAACAATGGGAAAGAAAAAGTGCATTTTATTTA
TTTAGTTTCATTGAATTTCTAAATTATCTTTACTGTTTTCTTGTTAGTTT
TTTTCTAGTTATGTTGAGGATTCTAACTGAAAAGGCACGCTTAATTTGTC
TAAGATGTTAGTCGCAGGGAACTTAAAAGCCAACGATAAAATACAAATAA
AATGACAAATCATTGTTTTGTTGAAAAAAGTTCTCGTTGTATTGTATGGA
CATAAAATACACAAATTATACTACTAGGATTTCGCTCTAAAGGTTCCTTT
TATAAACGTTAATTTGTTTTCGCAAATAAAATGGGAGATGAAATTTATGA
TCCCAACACTGGTAATTGTGCCATTTCATGTTTTATTTGAATCGGATCAG
AAATATAGAGTCCTCAGCAGTACAACCTCAAGCTCAAATTGGAATAGAAG
AAGATAATGGCCCTCAAGAGCATCAAGGACAATGTCGTTGCAAGCTAACT
AAGTGCTTAAAAATGTGAGTTAACTTCTATATGGAGCTCTCTAATTCAAA
TGATCACAAATTTGTTGTTTACTTCTTTTAATTTTATTTGTCAGACACTC
AGACCATAAATCTTGAGTTTGGCATATTTTAACGAATCTTTTGAGTTTAA
TATGAAAGAGAAATATTTGACCGTGAACATATTAAAGGCTAATGATGTGG
AATATAAACAAGATTATTATTTTAGACAGACTTTAAAGTCTTTGAAGTAG
AAATCGTATTTCTTGTATATATTGATAAATTAATTTAGTCTCTACCTCAG
AGCCTTGAATGGTATGGCTTACTAAAGCTACTAGATTTGATTACTTTCAT
GACGATGATCTACAAATTGTCAGGTACTGTGAATGCTTTTCTTCTGGATT
CTACTGCAATGGGTGCAATTGTATTGATTGTCACAATAACATCAAAAATG
AGCCTGCGAGGACTGCAGCTGTTGAAAGTATTTTAGAACGAAACCAAAAT
GCTTTCAGGTCAAAAACCGCTAACAGCTTGCATGTAACCCCAGATATTAA
GGTATGCAGGCTATAGTTGCTAGAATGTTTCCCTTTTTCTCAGGCTATAG
TTTGAAATTAGGTGGAAGTAGGATTTGTTTCTGTTGTTCTTCAATATTGT
CTTGTAACATGGGTTTTATATCACTGAAATTGGTCTTGATGCGACTTAAG
GTTCAGAAAAAGGGCACTACATCCGTAAGAAAACAACAAAAGGGGTGCCA
TTGTAAGAAAACATTTTGCCTAAAGAAATATTGCGAGTGCTTCCAAGCTA
AGATCCTCTGTTCTGAACATTGTAAATGCTTGGACTGCAAGAACGTAGAC
GGATTTGAGGAGAGTATACTATCACCTCAGAAACATTATGACGCAGAAAC
CTCTGTCAAGAGGGCCAGGGAGACATCTTCTTCAATATCAACTAAAAAAG
AAGGCCAGGTACTCTTCTCGTCCTAATGCTACAAAGGCAGAGAATGGCTT
CACTGAACTTACATGAACACATTAAAAGAAATTTGTTATTTTATTTTTAT
ACAGCCTTTTAGACCAGAAATGAACATAAATCCTTGCTCTTTATTGATTT
TGGCTGTTCAATTAAACATACATGTCAATTGCTCAACGTATTAATTTTCT
CCTCATTTTTATTTCACGTTTTATAATCTATGTTTAGCAGGGGAGTCCTC
TTGTAACTTTTAGGGCACCGCCTGCCTTTTCTGCCAATGCTCTCGAATGC
AGGTTCATATATTTAGAAACATACTTTTCTTTTATGCGCACTAGTTATAG
TTTCATAATTCTGACTCTGTTCATCATTATTGTGGGCACCACCAGATCAT
GGCAAGCAAGTATAACTACAGATTCCATTAAGCGCATTTGCTCAAATATG
TTTGTAGGGGCTCATGCTGATAGGATACTTACTGCAGGTATTATTTATTT
ATGAAGTTACGAAAGTTACAAGGATTATTTCTTTGCTCAAATGAATTGGT
AACTATTTGCAGGAAGAACGAATTAGTTATTTGTTTATATTATATTGTTT
TGTCCTCTTCTTCCACGTCTTTCAGGTTTTTTTCGCACTTTTTATTCAGT
CCTTTTGTTTTCTAAACTAAAAGTTAGTTCAACAAAATATTGAACAAATG
TTTATCCAAAGTTGCCAAACTAAGTACAAACGGGAACCTCGAATTTGTTC
TTCTAGTCAATAGTTTCACTTCAGTGAAGCCAGATAAACCAAATGTAGGG
GAAGTGGTTCCAGATGACCATTTGAATGATTATGGAGTAAACATAGTCAA
TACAAAGTTACCCAAAACTGCAAATGTCAATGGACAAGAAGGGATGGTGT
TATCTCCTACAGCAGAGGCGTTAAAATGTGATGAGAAAGTTACCATGTTG
AGAGAAGCTACTGCGTCCTTTGATGGAAATTATAAGCGGATCCCTAATGC
AAAGCCCTATATGGAGCAGGAAAGGATTATCTTGACAAACTTCCGGGATT
TTCTTAAGAAGATTATCTCTGTGAACACTAATTGTAAGATTTTATTTGAG
TTACAACATTAACGGTATTGCTTCCTTTATTTTTGTCAACTCTATAAACA
CTCCTCTTTCTCTATGCTTTACTGCATATCTCTTTTAAATCCTTATCTTT
ATAATTTTTCCTGTTCATTCAAAAATGCCAATCAAACAACACTTCACAAA
TTCTTGATCGAGCTCCATTTTTATTGCAGCAACTGGAACTTCTACAGGGA
TTCAATGTGACCATGTAGGTACTTGA