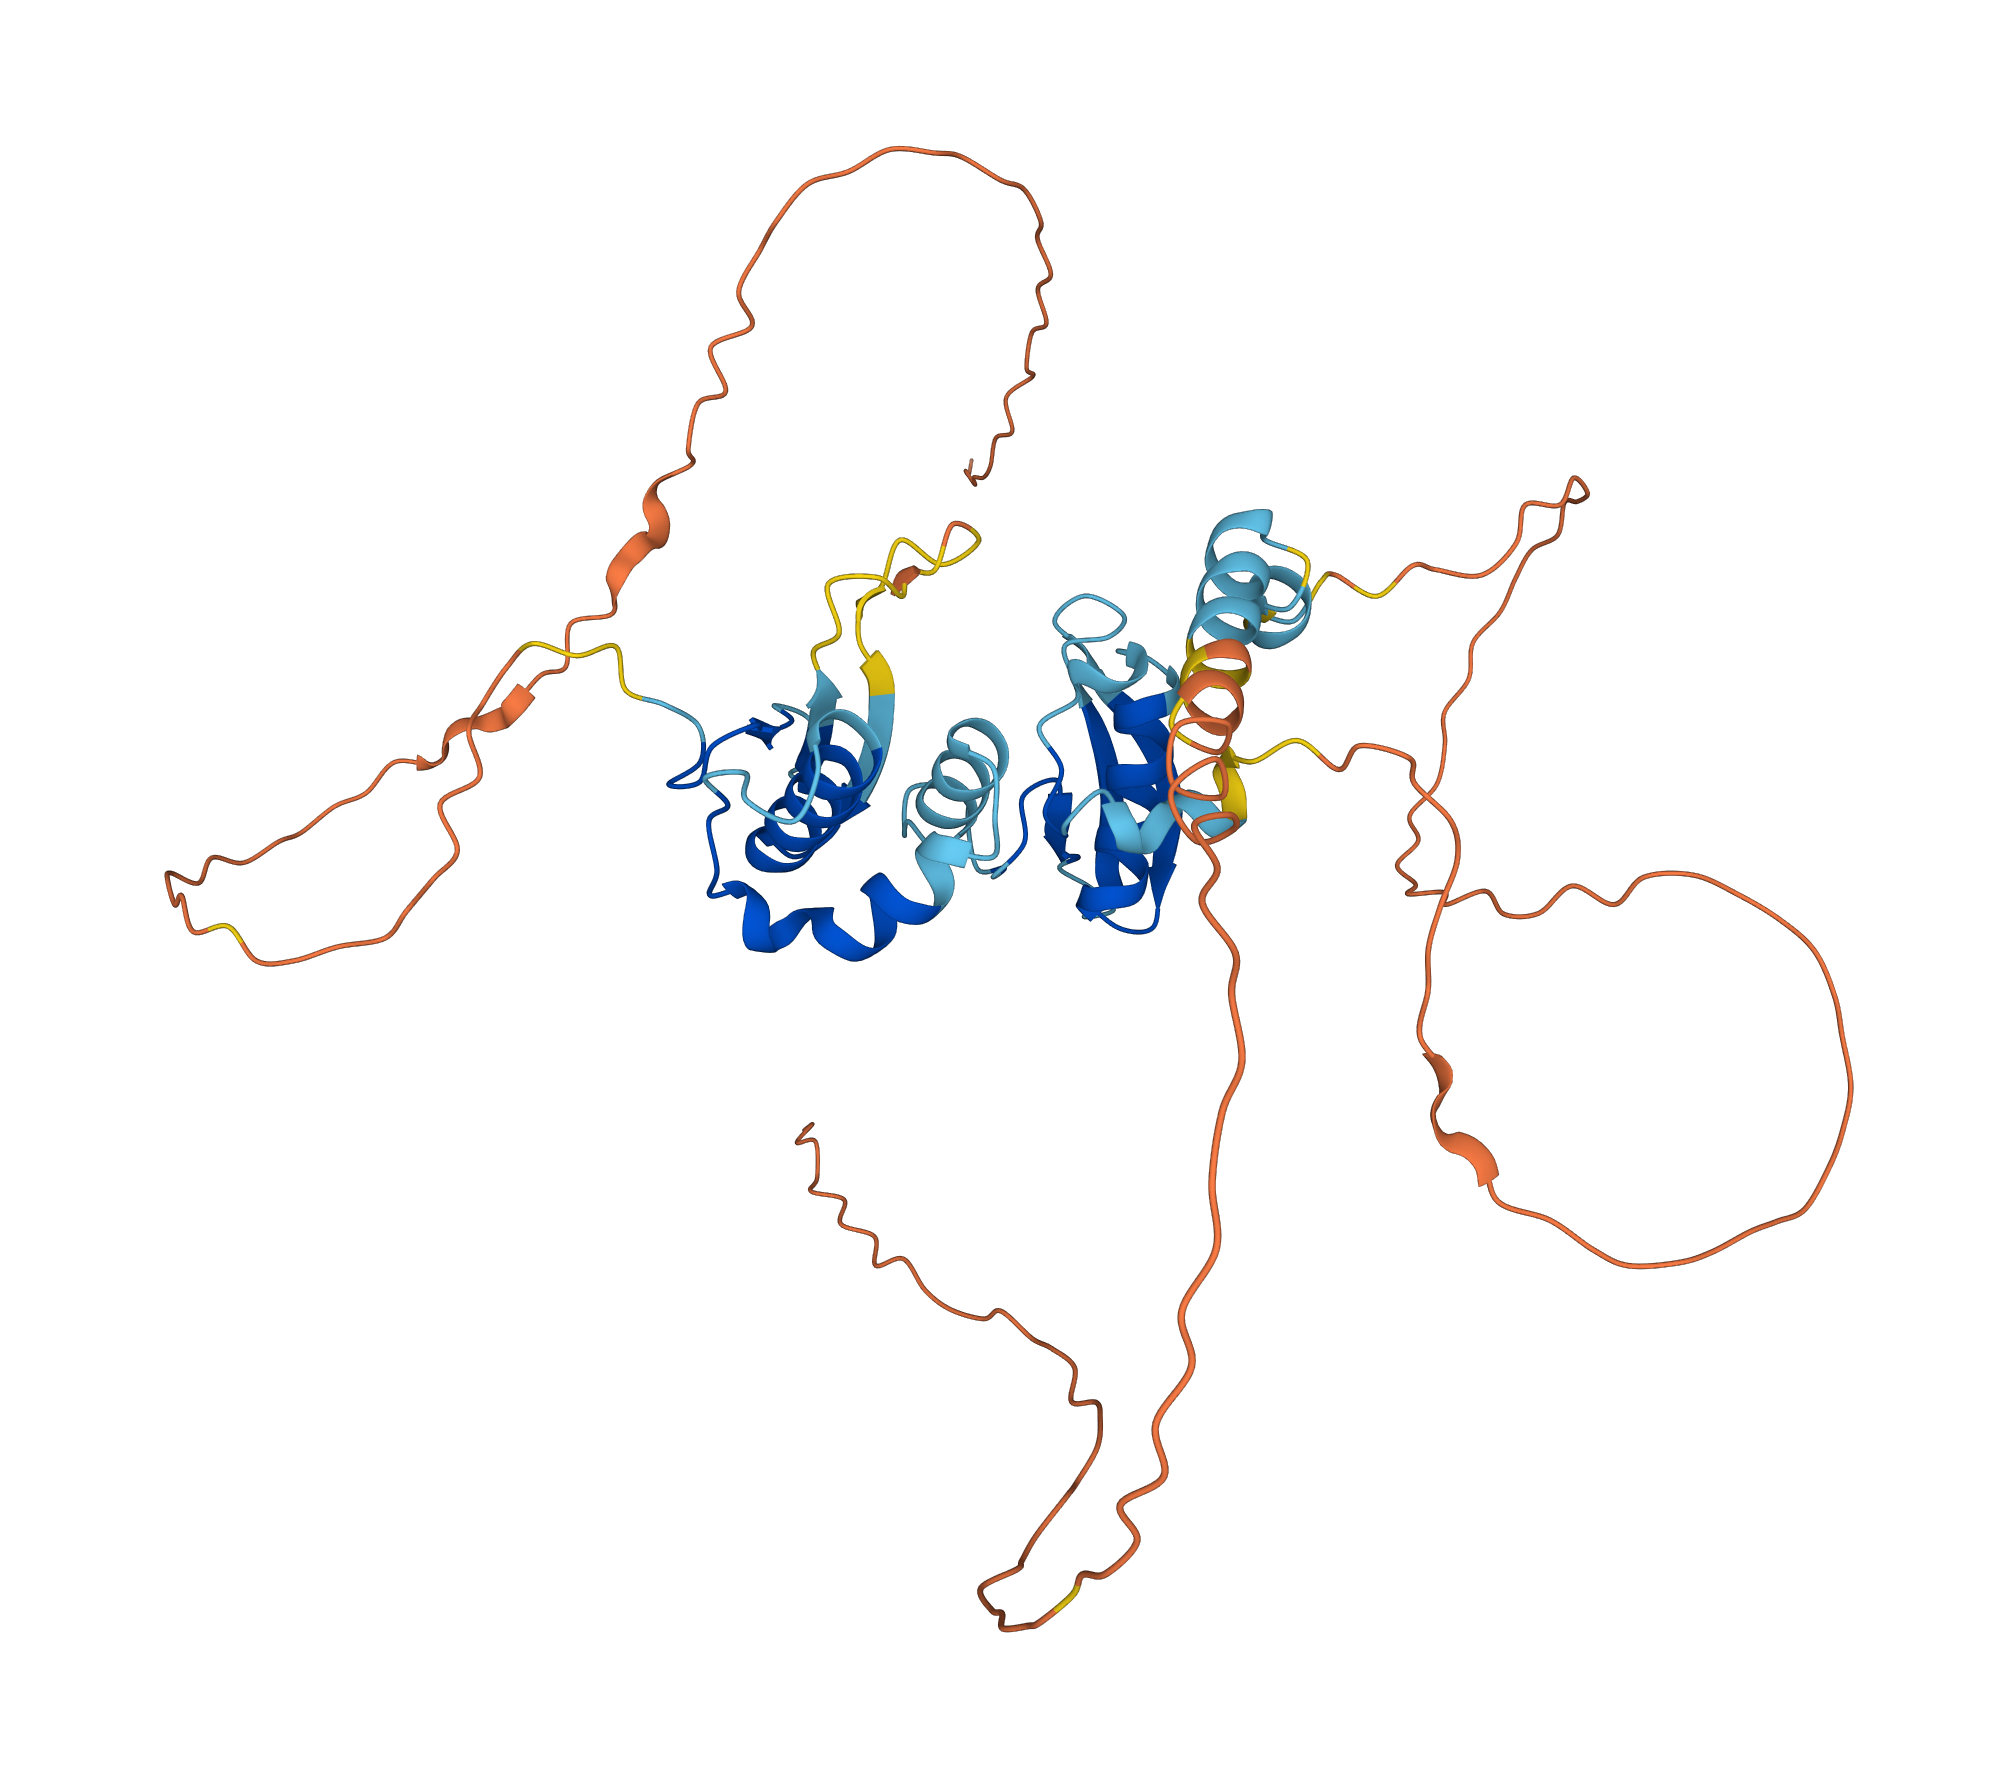
View Summary Pdf File Gene model: Cs_Cb2.08g331670.m01
IDENTIFICATION
- Species Name
- AP2
- Locus:
- Cs_Cb2.08g331670.m01
- Gene Model:
- Cs_Cb2.08g331670.m01
- Description:
- CsAP2-18
- Family:
- AP2
- 3D Structure:
- CsAP2-18
- Genome Databases:
- Tair
- Kegg
- External Resources
- GabiPD
- Gene Structure:
-

- Domain Architecture:
-

- Peptide Sequences
-
>CsAP2-18
MTVKSKMCPGKQHMCLFEGHNSNVMATKCVKRRRRDSTSVSQTYIDQQGH
QHVDQYVPITAATTSTTTTTTVKRSSRFRGVSRHRWTGRYEAHLWDKGFW
NPTQRKKGKQGAYDVEESAARAYDLAAVKYWGPTTFTNFPVSEYETEIEI
MQNVTKEEYLASLRRRSSGFSRGVSKYRGVARHHHNGRWEARIGRVFGNK
YLYLGTYSTQEEAAHAYDIAAIEYRGINAVTNFDLSTYIRWLRPVSNSAG
AEEQNPLTAHSKSQPYLIERNERAESSSLFHFNNPFVVNDIETSKRQAAI
SPCSSSTASPTALGLLFKSSIFRELVEKNLCVENEERVEDDEKKLGQDKN
DSFDMISFDGSIGPSLESNGETTLSFCNGRGQSFWNFPINMSSLHFN - CDS (Coding Sequence):
-
>CsAP2-18
ATGACAGTGAAATCTAAAATGTGCCCAGGAAAACAGCATATGTGCTTGTT
TGAAGGCCATAATAGTAATGTCATGGCTACTAAGTGTGTAAAGAGACGAA
GGAGAGATTCTACTTCTGTTTCACAAACCTACATAGATCAACAAGGTCAT
CAGCATGTTGATCAATATGTACCAATAACAGCAGCAACTACCTCTACTAC
TACTACTACTACTGTCAAACGAAGCTCCAGATTTCGCGGTGTCAGCAGGC
ATAGATGGACAGGTAGGTATGAGGCTCATTTATGGGACAAAGGGTTCTGG
AATCCAACTCAAAGGAAGAAGGGAAAGCAAGGAGCTTATGATGTAGAAGA
ATCTGCTGCCAGAGCTTATGATTTAGCAGCAGTTAAGTACTGGGGACCAA
CAACTTTTACCAATTTTCCAGTGTCAGAGTACGAGACAGAAATAGAGATA
ATGCAAAACGTTACAAAAGAAGAGTACTTGGCCTCTTTAAGAAGAAGAAG
TAGTGGCTTTTCAAGAGGTGTATCCAAGTACAGAGGAGTTGCAAGGCACC
ATCATAATGGAAGATGGGAAGCAAGGATCGGAAGAGTGTTTGGAAACAAA
TATCTTTATCTGGGCACTTATAGCACTCAAGAGGAGGCTGCCCATGCTTA
TGACATTGCAGCAATAGAATATAGAGGCATTAATGCAGTGACAAACTTTG
ACTTGAGCACTTACATAAGATGGCTTAGACCAGTATCAAATTCTGCTGGA
GCTGAAGAACAAAATCCTCTAACTGCACACTCCAAGTCTCAGCCTTACCT
CATTGAAAGAAATGAAAGAGCAGAGAGTTCATCATTATTCCATTTCAACA
ACCCATTTGTAGTAAATGACATAGAAACCTCGAAACGACAAGCAGCCATA
AGCCCTTGCAGCAGCAGCACTGCTTCTCCAACAGCTCTTGGACTCCTATT
CAAGTCATCAATATTCAGGGAGCTGGTTGAGAAGAATTTGTGTGTTGAGA
ACGAAGAAAGAGTGGAGGATGATGAGAAGAAGCTTGGGCAGGATAAGAAC
GATAGCTTTGATATGATTTCCTTTGATGGTAGTATTGGCCCTAGTTTGGA
GTCCAATGGAGAGACCACATTGTCGTTTTGTAATGGAAGGGGACAATCCT
TTTGGAATTTTCCAATAAACATGTCTTCTCTTCATTTCAACTAA - Nucleotide:
-
>CsAP2-18
ATGACAGTGAAATCTAAAATGTGCCCAGGAAAACAGCATATGTGCTTGTT
TGAAGGCCATAATAGTAATGTCATGGCTACTAAGTGTGTAAAGAGACGAA
GGAGAGATTCTACTTCTGTTTCACAAACCTACATAGATCAACAAGGTCAT
CAGCATGTTGATCAATATGTACCAATAACAGCAGCAACTACCTCTACTAC
TACTACTACTACTGTCAAACGAAGCTCCAGATTTCGCGGTGTCAGCAGGT
TTGGCAAACAGACATAACTCCATGTACTTTTTTTTTAAGTATGGAAATGT
GGAACGTTATTAGTTGATTTGGATTGAGTAAATGAATTAAAGAAACATTA
TAATGCAGGCATAGATGGACAGGTAGGTATGAGGCTCATTTATGGGACAA
AGGGTTCTGGAATCCAACTCAAAGGAAGAAGGGAAAGCAAGGTATATTAG
TACTTGTCTATTTCTAAATTATGCTGACACTTTTACTCGTATCTATCAAT
TATCTTTACTGATTCTAATCAATGTTTCTTTGTTGCTAACTGTAAACGCA
TTGGATGGTAATGGAGCAGTTTATTTGGGTAAGTAATTTGTAGCTTATCA
AGGCCATTTTTACTTGCAAAAGATGATAAATCATAATTATTGGGGAAACT
AACAACTTAATGGATCGGTAAACTAAACAGGAGCTTATGATGTAGAAGAA
TCTGCTGCCAGAGCTTATGATTTAGCAGCAGTTAAGTACTGGGGACCAAC
AACTTTTACCAATTTTCCAGTAAGTTGAGATAATAGAGCATGAAAATGGG
GGAGCTCTTGAAGCACTTTTTGAACAAAAAAGTAGCCATATCAACTTTGA
TTTCTTTATGTTAAGTCTTTTTTGATGAATGTTTCTCTGCAGGTGTCAGA
GTACGAGACAGAAATAGAGATAATGCAAAACGTTACAAAAGAAGAGTACT
TGGCCTCTTTAAGAAGGTATCAGCTGCACATTTATGGACTTTAAATTCTC
CTAATGAGCTCTAAACTTATAGTTCTTTTCTTCCATGTATAAAGAAGAAG
TAGTGGCTTTTCAAGAGGTGTATCCAAGTACAGAGGAGTTGCAAGGTACT
TAAATTTTATTACCTTCAAAGTTGTTATTTATTGTAGACTATTTAGTAAT
GAAATTTCATTTAAGGTTGAATTCTTGAATGAATTGTAGGCACCATCATA
ATGGAAGATGGGAAGCAAGGATCGGAAGAGTGTTTGGAAACAAATATCTT
TATCTGGGCACTTATAGTGAGTTTAATTAGTCCCATGTATCATTGAAGAA
GTCCAAGTAGATAAGAAGACTAATCTCTTTTATTACAATAATCGTTACAG
GCACTCAAGAGGAGGCTGCCCATGCTTATGACATTGCAGCAATAGAATAT
AGAGGCATTAATGCAGTGACAAACTTTGACTTGAGCACTTACATAAGATG
GCTTAGACCAGTATCAAATTCTGCTGGAGCTGAAGAACAAAATCCTCTAA
CTGCACACTCCAAGTCTCAGCCTTACCTCATTGAAAGAAATGAAAGAGCA
GAGAGTTCATCATTATTCCATTTCAACAACCCATTTGTAGTAAATGACAT
AGAAACCTCGAAACGACAAGCAGCCATAAGCCCTTGCAGCAGCAGCACTG
CTTCTCCAACAGCTCTTGGACTCCTATTCAAGTCATCAATATTCAGGGAG
CTGGTTGAGAAGAATTTGTGTGTTGAGAACGAAGAAAGAGTGGAGGATGA
TGAGAAGAAGCTTGGGCAGGATAAGAACGATAGCTTTGATATGATTTCCT
TTGATGGTAGTATTGGCCCTAGTTTGGAGTCCAATGGAGAGACCACATTG
TCGTTTTGTAATGGAAGGGGACAATCCTTTTGGAATTTTCCAATAAACAT
GTCTTCTCTTCATTTCAACTAA