View Summary Pdf File Gene model: Cs_Cb2.08g331640.m01
IDENTIFICATION
- Species Name
- AP2
- Locus:
- Cs_Cb2.08g331640.m01
- Gene Model:
- Cs_Cb2.08g331640.m01
- Description:
- CsAP2-17
- Family:
- AP2
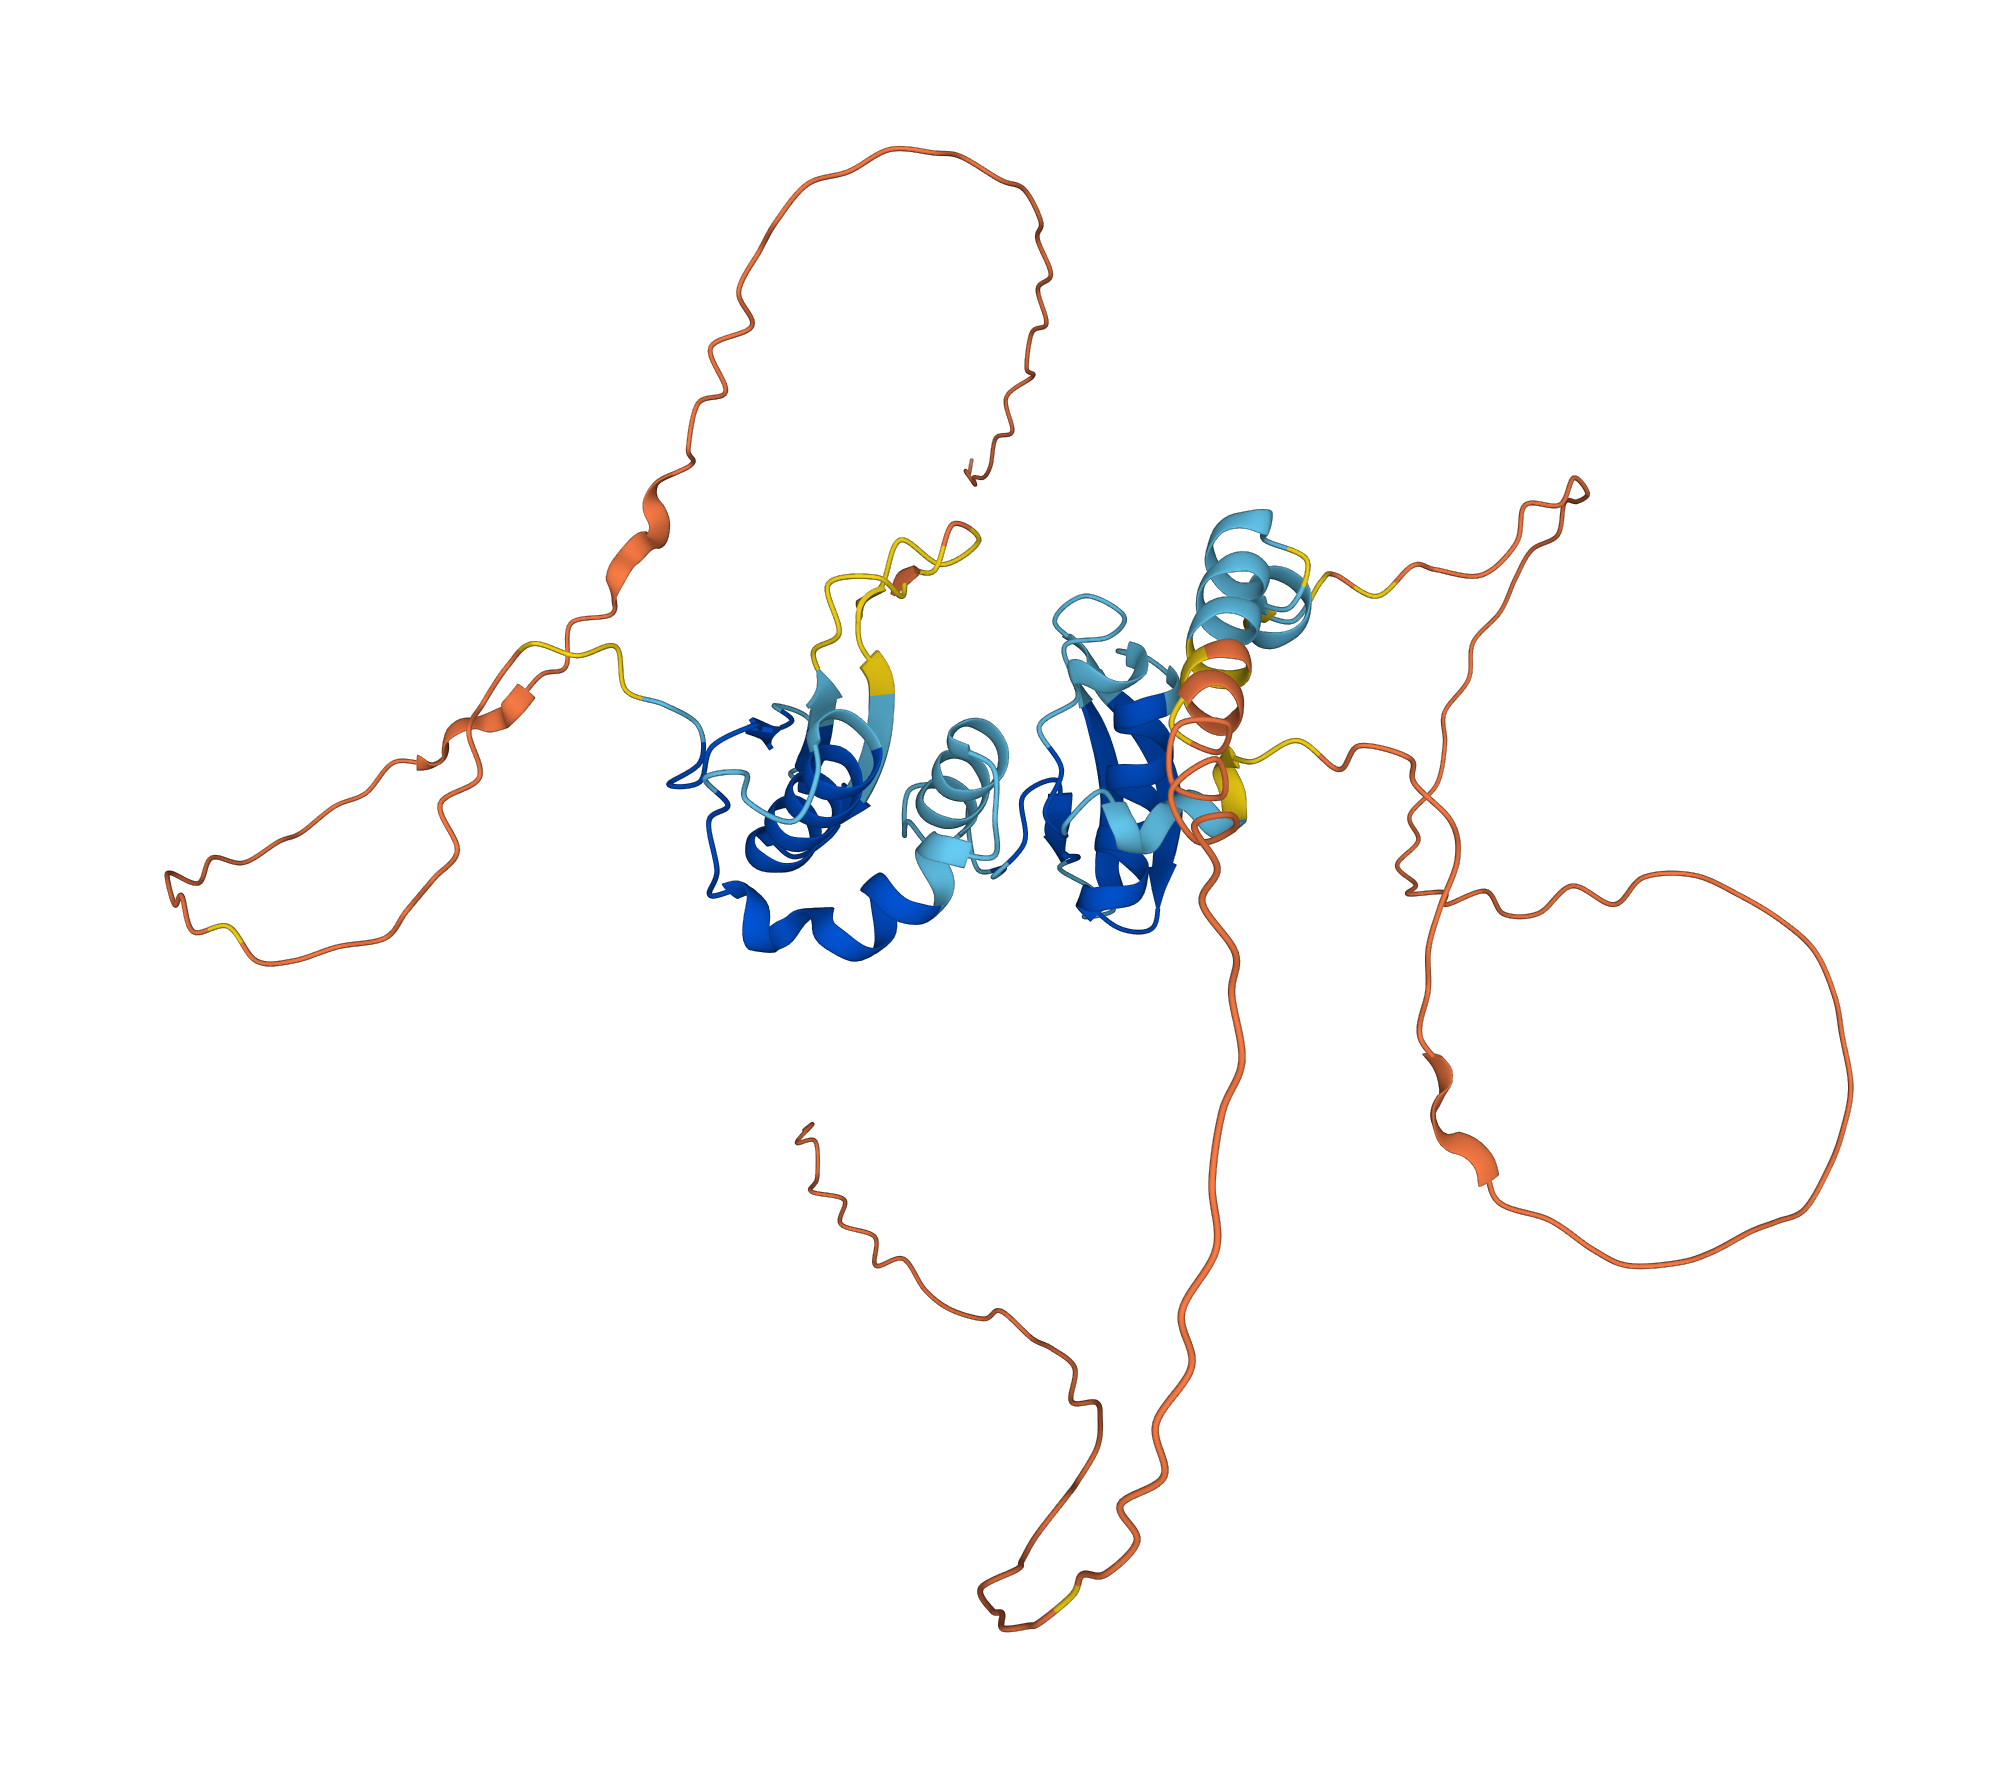
- 3D Structure:
- CsAP2-17
- Genome Databases:
- Tair
- Kegg
- External Resources
- GabiPD
- Gene Structure:
-

- Domain Architecture:
-

- Peptide Sequences
-
>CsAP2-17
MEMTVKSKMCPGKQHMCLFEGHNSNVMATKCVKRRRRDSTSVSQTYIDQQ
GHQHVDQYVPITAATTSTTTTTVKRSSRFRGVSRHRWTGRYEAHLWDKGF
WNPTQRKKGKQGAYDVEESAARAYDLAAVKYWGPTTFTNFPVSEYETEIE
IMQNVTKEEYLASLRRRSSGFSRGVSKYRGVARHHHNGRWEARIGRVFGN
KYLYLGTYSTQEEAAHAYDIAAIEYRGINAVTNFDLSTYIRWLRPVSNSA
GAEEQNPLTANSKSQPYLIERNERAESSSLFHFNNPFVVNDIETSKRQAA
ISPCSSSTASPTALGLLFKSSIFRELVEKNLCVENKERVEDDEKKLGQDK
NDSFDMISFDGSIGPSLESNGESTLSFCNGRGQSFWNFPINMSSLHFN - CDS (Coding Sequence):
-
>CsAP2-17
ATGGAAATGACAGTGAAATCTAAAATGTGCCCAGGAAAACAGCATATGTG
CTTGTTTGAAGGCCATAATAGTAATGTCATGGCTACTAAGTGTGTAAAGA
GACGAAGGAGAGATTCTACTTCTGTTTCACAAACCTACATAGATCAACAA
GGTCATCAGCATGTTGATCAATATGTACCAATAACAGCAGCAACTACCTC
TACTACTACTACTACTGTCAAACGAAGCTCCAGATTTCGCGGTGTCAGCA
GGCATAGATGGACAGGTAGGTATGAGGCTCATTTATGGGACAAAGGGTTC
TGGAATCCAACTCAAAGGAAGAAGGGAAAGCAAGGAGCTTATGATGTAGA
AGAATCTGCTGCCAGAGCTTATGATTTAGCAGCAGTTAAGTACTGGGGAC
CAACAACTTTTACCAATTTTCCAGTGTCAGAGTACGAGACAGAAATAGAG
ATAATGCAAAACGTTACAAAAGAAGAGTACTTGGCCTCTTTAAGAAGAAG
AAGTAGTGGCTTTTCAAGAGGTGTATCCAAGTACAGAGGAGTTGCAAGGC
ACCATCATAATGGAAGATGGGAAGCAAGGATAGGAAGAGTGTTTGGAAAC
AAATATCTTTATCTGGGCACTTATAGCACTCAAGAGGAGGCTGCCCATGC
TTATGACATTGCAGCAATAGAATATAGAGGCATTAATGCAGTGACAAACT
TTGACTTGAGCACTTACATAAGATGGCTTAGACCAGTATCAAATTCTGCT
GGAGCTGAAGAACAAAATCCTCTAACTGCAAACTCCAAGTCTCAGCCTTA
CCTCATTGAAAGAAATGAAAGAGCAGAGAGTTCATCATTATTCCATTTCA
ACAACCCATTTGTAGTAAATGACATAGAAACCTCGAAACGACAAGCAGCC
ATAAGTCCTTGCAGCAGCAGCACTGCTTCTCCAACAGCTCTTGGACTCCT
ATTCAAGTCATCAATATTCAGGGAGCTGGTTGAGAAGAATTTGTGTGTTG
AGAACAAAGAAAGAGTGGAGGATGATGAGAAGAAGCTTGGGCAGGATAAG
AACGATAGCTTTGATATGATTTCCTTTGATGGTAGTATTGGCCCTAGTTT
GGAGTCCAATGGAGAGAGCACATTGTCGTTTTGTAATGGAAGGGGACAAT
CCTTTTGGAATTTTCCAATAAACATGTCTTCTCTTCATTTCAACTAA - Nucleotide:
-
>CsAP2-17
ATGGAAATGACAGTGAAATCTAAAATGTGCCCAGGAAAACAGCATATGTG
CTTGTTTGAAGGCCATAATAGTAATGTCATGGCTACTAAGTGTGTAAAGA
GACGAAGGAGAGATTCTACTTCTGTTTCACAAACCTACATAGATCAACAA
GGTCATCAGCATGTTGATCAATATGTACCAATAACAGCAGCAACTACCTC
TACTACTACTACTACTGTCAAACGAAGCTCCAGATTTCGCGGTGTCAGCA
GGTTTGGCAAACAGACATAACTCCATGTACTTTTTTTTTAAGTATGGAAA
TGTGGAACGTTATTAGTTGATTTGGATTGAGTAAATGAATTAAAGAAACA
TTATAATGCAGGCATAGATGGACAGGTAGGTATGAGGCTCATTTATGGGA
CAAAGGGTTCTGGAATCCAACTCAAAGGAAGAAGGGAAAGCAAGGTATAT
TAGTACTTGTCTATTTCTAAATTATGCTGACACTTTTACTCGTATCTATC
AATTATCTTTACTGATTCTAATCAATGTTTCTTTGTTGCTAACTGTAAAC
GCATTGGATGGTAATGGAGCAGTTTATTTGGGTAAGTAATTTGTAGCTTA
TCAAGGCCATTTTTACTTGCAAAAGATGATAAATCATAATTATTGGGGAA
ACTAACAACTTAATGGATCGGTAAACTAAACAGGAGCTTATGATGTAGAA
GAATCTGCTGCCAGAGCTTATGATTTAGCAGCAGTTAAGTACTGGGGACC
AACAACTTTTACCAATTTTCCAGTAAGTTGAGATAATAGAGCATGAAAAT
GGGGGAGCTCTTGAAGCACTTTTTGAACAAAAAAGTAGCCATATCAACTT
TGATTTCTTTATGTTAAGTCTTTTTTGATGAATGTTTCTCTGCAGGTGTC
AGAGTACGAGACAGAAATAGAGATAATGCAAAACGTTACAAAAGAAGAGT
ACTTGGCCTCTTTAAGAAGGTATCAGCTGCACATTTATGGACTTTAAATT
CTCCTAATGAGTTCTAAATTTATAGTTCTTTTCTTCCATGTATAAAGAAG
AAGTAGTGGCTTTTCAAGAGGTGTATCCAAGTACAGAGGAGTTGCAAGGT
ACTTAAATTTTATTACCTTCAAAGTTGTTATTTATTGTAGACTATTTAGT
AATGAAATTTCATTTAAGGTTGAATTCTTGAATGAATTGTAGGCACCATC
ATAATGGAAGATGGGAAGCAAGGATAGGAAGAGTGTTTGGAAACAAATAT
CTTTATCTGGGCACTTATAGTGAGTTTAATTAGTCCCATGTATCATTGAA
GAAGTCCAAGTAGATAAGAAGACTAATCTCTTTTATTACAATAATCGTTA
CAGGCACTCAAGAGGAGGCTGCCCATGCTTATGACATTGCAGCAATAGAA
TATAGAGGCATTAATGCAGTGACAAACTTTGACTTGAGCACTTACATAAG
ATGGCTTAGACCAGTATCAAATTCTGCTGGAGCTGAAGAACAAAATCCTC
TAACTGCAAACTCCAAGTCTCAGCCTTACCTCATTGAAAGAAATGAAAGA
GCAGAGAGTTCATCATTATTCCATTTCAACAACCCATTTGTAGTAAATGA
CATAGAAACCTCGAAACGACAAGCAGCCATAAGTCCTTGCAGCAGCAGCA
CTGCTTCTCCAACAGCTCTTGGACTCCTATTCAAGTCATCAATATTCAGG
GAGCTGGTTGAGAAGAATTTGTGTGTTGAGAACAAAGAAAGAGTGGAGGA
TGATGAGAAGAAGCTTGGGCAGGATAAGAACGATAGCTTTGATATGATTT
CCTTTGATGGTAGTATTGGCCCTAGTTTGGAGTCCAATGGAGAGAGCACA
TTGTCGTTTTGTAATGGAAGGGGACAATCCTTTTGGAATTTTCCAATAAA
CATGTCTTCTCTTCATTTCAACTAA