View Summary Pdf File Gene model: Cs_Cb2.04g153120.m01
IDENTIFICATION
- Species Name
- AP2
- Locus:
- Cs_Cb2.04g153120.m01
- Gene Model:
- Cs_Cb2.04g153120.m01
- Description:
- CsAP2-14
- Family:
- AP2
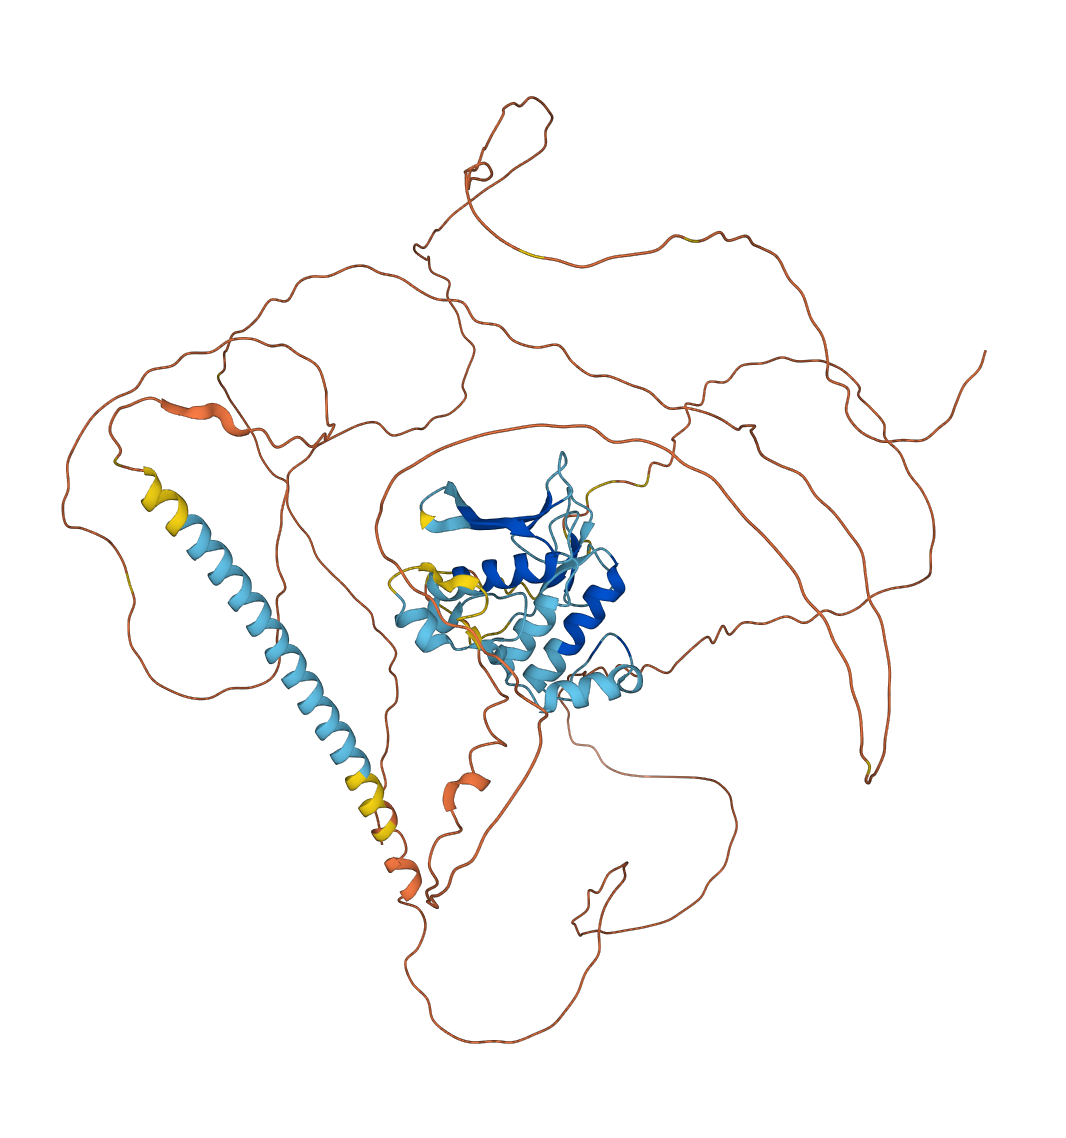
- 3D Structure:
- CsAP2-14
- Genome Databases:
- Tair
- Kegg
- External Resources
- GabiPD
- Gene Structure:
-

- Domain Architecture:
-

- Peptide Sequences
-
>CsAP2-14
MPLKSDGSLCIMEALTRSQPQATMVTTSTPKLEDFFGSGTMGSHHYESND
REVMALSLDNSMFFNQNPEHEEPNNHHHQNFLNQLQQQQQQQQQQQQQQQ
QQSSRHQDHQAQQIQAQQQYSYYSGLRSHDIAAAAAASADCNLQLPTMAD
NGISEMKNWVSRNYSGNHGLEQKMIGGCMADNGGESGSINGMAYGDLQSL
SLSMSPGSQSSCVTGSQKQQQISPPVTDCVAIDTKKRGPEKVDQKQIVHR
KSLDTFGQRTSQYRGVTRHRWTGRYEAHLWDNSCKKEGQSRKGRQGGYDM
EEKAARSYDLAALKYWGPSTHINFPLENYHKELEEMKNMTRQEYVAHLRR
KSSGFSRGASMYRGVTRHHQHGRWQARIGRVAGNKDLYLGTFSTQEEAAE
AYDIAAIKFRGLNAVTNFDITRYDVDRIMASNTLLAGELAKRTKDVGSAA
IEAANQNSASSSINEEAITPKNNEGESDWKMALYHSSSTQQQQHQLVQKP
LSMDNSYKGESYSVVAPENMIHQLEVEDSAKMGTHMSNASSLVTSLSSSR
EGSPDKSSLPGLLYGVPPSVSKFFTNPANDVSSWIPTTQQRSALSMPHMP
IFAAWTDT - CDS (Coding Sequence):
-
>CsAP2-14
ATGCCACTTAAGTCTGATGGTTCACTTTGTATAATGGAAGCTCTAACCAG
GTCCCAGCCTCAAGCAACAATGGTCACAACTTCTACTCCAAAACTTGAAG
ACTTCTTTGGAAGTGGAACAATGGGGTCTCATCACTATGAAAGCAATGAC
AGAGAAGTAATGGCTCTGAGCTTAGACAACAGTATGTTCTTTAATCAAAA
CCCAGAACACGAGGAGCCCAACAACCACCACCACCAAAATTTTCTAAACC
AACTACAACAACAACAGCAACAACAACAACAACAACAACAGCAGCAGCAG
CAACAGAGCTCTAGGCACCAAGATCATCAAGCCCAGCAAATTCAAGCTCA
GCAACAGTATTCATACTACTCTGGTCTGAGAAGCCATGATATTGCTGCTG
CTGCTGCTGCTTCTGCTGACTGTAATCTCCAGCTTCCGACAATGGCTGAT
AATGGGATTTCTGAAATGAAGAACTGGGTCTCAAGGAACTATTCAGGTAA
CCATGGATTGGAGCAGAAGATGATTGGTGGTTGCATGGCTGACAATGGAG
GTGAGTCTGGCTCTATTAATGGAATGGCTTATGGTGATTTACAGTCATTG
AGCTTGTCCATGAGTCCTGGCTCCCAATCCAGTTGTGTTACTGGTTCACA
GAAGCAGCAGCAAATATCACCTCCTGTGACCGATTGTGTAGCCATTGATA
CGAAGAAAAGAGGGCCTGAGAAGGTAGATCAAAAGCAAATCGTCCATAGG
AAGTCCTTAGATACATTTGGCCAGAGAACCTCTCAATACAGAGGTGTCAC
AAGGCATAGATGGACTGGTAGATATGAAGCTCATTTATGGGACAACAGTT
GCAAGAAAGAAGGGCAAAGCAGAAAAGGAAGACAAGGAGGATATGATATG
GAAGAAAAAGCTGCAAGATCTTATGATTTAGCTGCACTTAAGTATTGGGG
TCCCTCTACTCATATCAATTTTCCGTTGGAAAATTATCATAAAGAACTTG
AAGAAATGAAAAATATGACCAGACAGGAATATGTTGCTCATCTAAGAAGG
AAAAGCAGTGGGTTTTCAAGGGGAGCTTCAATGTATAGAGGAGTAACAAG
ACATCATCAGCATGGACGTTGGCAAGCTCGGATTGGGAGAGTGGCTGGTA
ACAAAGATCTATACCTTGGGACATTCAGTACTCAAGAGGAAGCAGCTGAA
GCTTATGACATTGCAGCCATAAAGTTTAGAGGATTAAATGCAGTAACTAA
CTTTGACATAACAAGGTATGATGTGGATCGGATTATGGCTAGTAATACCC
TTTTAGCGGGAGAACTCGCTAAGCGAACCAAGGACGTTGGAAGCGCTGCC
ATTGAGGCTGCAAATCAAAATTCTGCCTCTAGTAGCATCAATGAAGAAGC
TATAACCCCAAAAAACAACGAAGGCGAATCAGATTGGAAAATGGCACTAT
ACCATTCCTCCTCGACGCAGCAGCAGCAGCATCAACTTGTCCAGAAACCA
CTTAGCATGGACAACAGCTACAAGGGCGAATCTTATTCGGTTGTTGCCCC
AGAGAATATGATTCACCAGCTCGAGGTAGAAGACTCTGCAAAAATGGGGA
CTCACATGTCAAATGCTTCATCATTGGTGACAAGTTTAAGCAGCTCAAGG
GAAGGTAGCCCGGATAAGAGCAGCCTCCCGGGGCTGCTGTACGGTGTGCC
TCCATCTGTGTCAAAGTTCTTTACTAATCCAGCAAATGATGTGAGTTCAT
GGATCCCAACCACTCAACAGAGATCTGCACTATCCATGCCTCACATGCCA
ATTTTTGCTGCTTGGACAGATACTTAA - Nucleotide:
-
>CsAP2-14
ATGCCACTTAAGTCTGATGGTTCACTTTGTATAATGGAAGCTCTAACCAG
GTCCCAGCCTCAAGGTTTGTTCAAAACAAAGCTCCTTTTTTTCTTTCACA
CTTAGAATCACTTATTCTGGTTTTCTGACTTTTTTTTTCTTTTCTGAATG
TTAAGCAACAATGGTCACAACTTCTACTCCAAAACTTGAAGACTTCTTTG
GAAGTGGAACAATGGGGTCTCATCACTATGAAAGCAATGACAGAGAAGTA
ATGGCTCTGAGCTTAGACAACAGTATGTTCTTTAATCAAAACCCAGAACA
CGAGGAGCCCAACAACCACCACCACCAAAATTTTCTAAACCAACTACAAC
AACAACAGCAACAACAACAACAACAACAACAGCAGCAGCAGCAACAGAGC
TCTAGGCACCAAGATCATCAAGCCCAGCAAATTCAAGCTCAGCAACAGTA
TTCATACTACTCTGGTCTGAGAAGCCATGATATTGCTGCTGCTGCTGCTG
CTTCTGCTGACTGTAATCTCCAGCTTCCGACAATGGCTGATAATGGGATT
TCTGAAATGAAGAACTGGGTCTCAAGGAACTATTCAGGTAACCATGGATT
GGAGCAGAAGATGATTGGTGGTTGCATGGCTGACAATGGAGGTGAGTCTG
GCTCTATTAATGGAATGGCTTATGGTGATTTACAGTCATTGAGCTTGTCC
ATGAGTCCTGGCTCCCAATCCAGTTGTGTTACTGGTTCACAGAAGCAGCA
GCAAATATCACCTCCTGTGACCGATTGTGTAGCCATTGATACGAAGAAAA
GAGGGCCTGAGAAGGTAGATCAAAAGCAAATCGTCCATAGGAAGTCCTTA
GATACATTTGGCCAGAGAACCTCTCAATACAGAGGTGTCACAAGGTTGGT
CCTTTTTCATTTATTATTATTATTATTATCTTTTCTTGTTTAGTGAATCT
TCTTTAATGGGTTTTGGTTAATAATGAATCAGGCATAGATGGACTGGTAG
ATATGAAGCTCATTTATGGGACAACAGTTGCAAGAAAGAAGGGCAAAGCA
GAAAAGGAAGACAAGGTTAGAGAACACTTTATTAGTTTAAAAGGGCATGT
CCTTTTATTGTCTCTTGTCATAAGAGGAACTGATTCTTATTCTTGTTTCT
TCATTCTTGCTTCGACCCAATGATGCCACTTCAATTGTTTGGCTACATCA
GTTTATCTTGGTAAGGTTCTCTTTTTTTTATTTTTTATTTTTTTCCCTTT
TCATATGTTGCTTGTTGCCACTTTAATATATATATATATATTATATTTAT
TTACATGATGCTCTTATGATGAATATGTCTCATTGTTCATGATGTTTTTA
CCTCAGGAGGATATGATATGGAAGAAAAAGCTGCAAGATCTTATGATTTA
GCTGCACTTAAGTATTGGGGTCCCTCTACTCATATCAATTTTCCGGTGAG
GATTTTGTGCTCTCTCTCTTGACTTTTCCTTTTTTTATTTTTATTTTACT
GATGCAACTAGTAATTTTGTGTTTTGACAGTTGGAAAATTATCATAAAGA
ACTTGAAGAAATGAAAAATATGACCAGACAGGAATATGTTGCTCATCTAA
GAAGGTAGCTATAGCTCTTTCTCTTATGTTATTGATAATGGCACTCTTCT
TTTTCTTTCTTCTTAATCTTTCTTTTACTTTTTATACTTGGTCACTTTAC
TATCAAATCTTTCTTCACCAGGAAAAGCAGTGGGTTTTCAAGGGGAGCTT
CAATGTATAGAGGAGTAACAAGGTATATTTTGACTTTGTCTAAGCTTTTC
ACCATTTATTTTATACATTATGTTAGCTAAAAACAAATTATTATATGACC
CTAAAATCTTTGTTTACAGACATCATCAGCATGGACGTTGGCAAGCTCGG
ATTGGGAGAGTGGCTGGTAACAAAGATCTATACCTTGGGACATTCAGTGA
GTATTTTCAAATTTCAGACTTGACTCGATTGTTGCAAAAATCTAGACTTG
GCTAAAGAATCATCATTTTCAAAATAATTATTAACAAATTATTAAAATAA
TAGGAGAGAATTTAGTTAGCATCATTTCAAACTTTTTGGGCTCGGTTATG
CTTGTGACACTTTTGAAATTGTGTACGGGTCTGTAATAAGTCAGTCAAAT
GAGCTTTTGCTAAAGCTGCTCTTTCAGACGTTATACACACTGAAAATATA
ACTTTGATTCTTACTTTGGAATGATGTGTTACAATCAATTTATGATTTTC
ACCAAAGTTAAAAATTAAATATCTTTTACAATTATCTCTTCATTAATAGG
TACTCAAGAGGAAGCAGCTGAAGCTTATGACATTGCAGCCATAAAGTTTA
GAGGATTAAATGCAGTAACTAACTTTGACATAACAAGGTATGATGTGGAT
CGGATTATGGCTAGTAATACCCTTTTAGCGGGAGAACTCGCTAAGCGAAC
CAAGGACGTTGGAAGCGCTGCCATTGAGGCTGCAAATCAAAATTCTGCCT
CTAGTAGCATCAATGAAGAAGCTATAACCCCAAAAAACAACGAAGGCGAA
TCAGATTGGAAAATGGCACTATACCATTCCTCCTCGACGCAGCAGCAGCA
GCATCAACTTGTCCAGAAACCACTTAGCATGGACAACAGCTACAAGGGCG
AATCTTATTCGGTTGTTGCCCCAGAGAATATGATTCACCAGCTCGAGGTA
GAAGACTCTGCAAAAATGGGGACTCACATGTCAAATGCTTCATCATTGGT
GACAAGTTTAAGCAGCTCAAGGGAAGGTAGCCCGGATAAGAGCAGCCTCC
CGGGGCTGCTGTACGGTGTGCCTCCATCTGTGTCAAAGTTCTTTACTAAT
CCAGCAAATGATGTGAGTTCATGGATCCCAACCACTCAACAGAGATCTGC
ACTATCCATGCCTCACATGCCAATTTTTGCTGCTTGGACAGATACTTAA