View Summary Pdf File Gene model: Cs_Cb2.02g213810.m01
IDENTIFICATION
- Species Name
- AP2
- Locus:
- Cs_Cb2.02g213810.m01
- Gene Model:
- Cs_Cb2.02g213810.m01
- Description:
- CsAP2-05
- Family:
- AP2
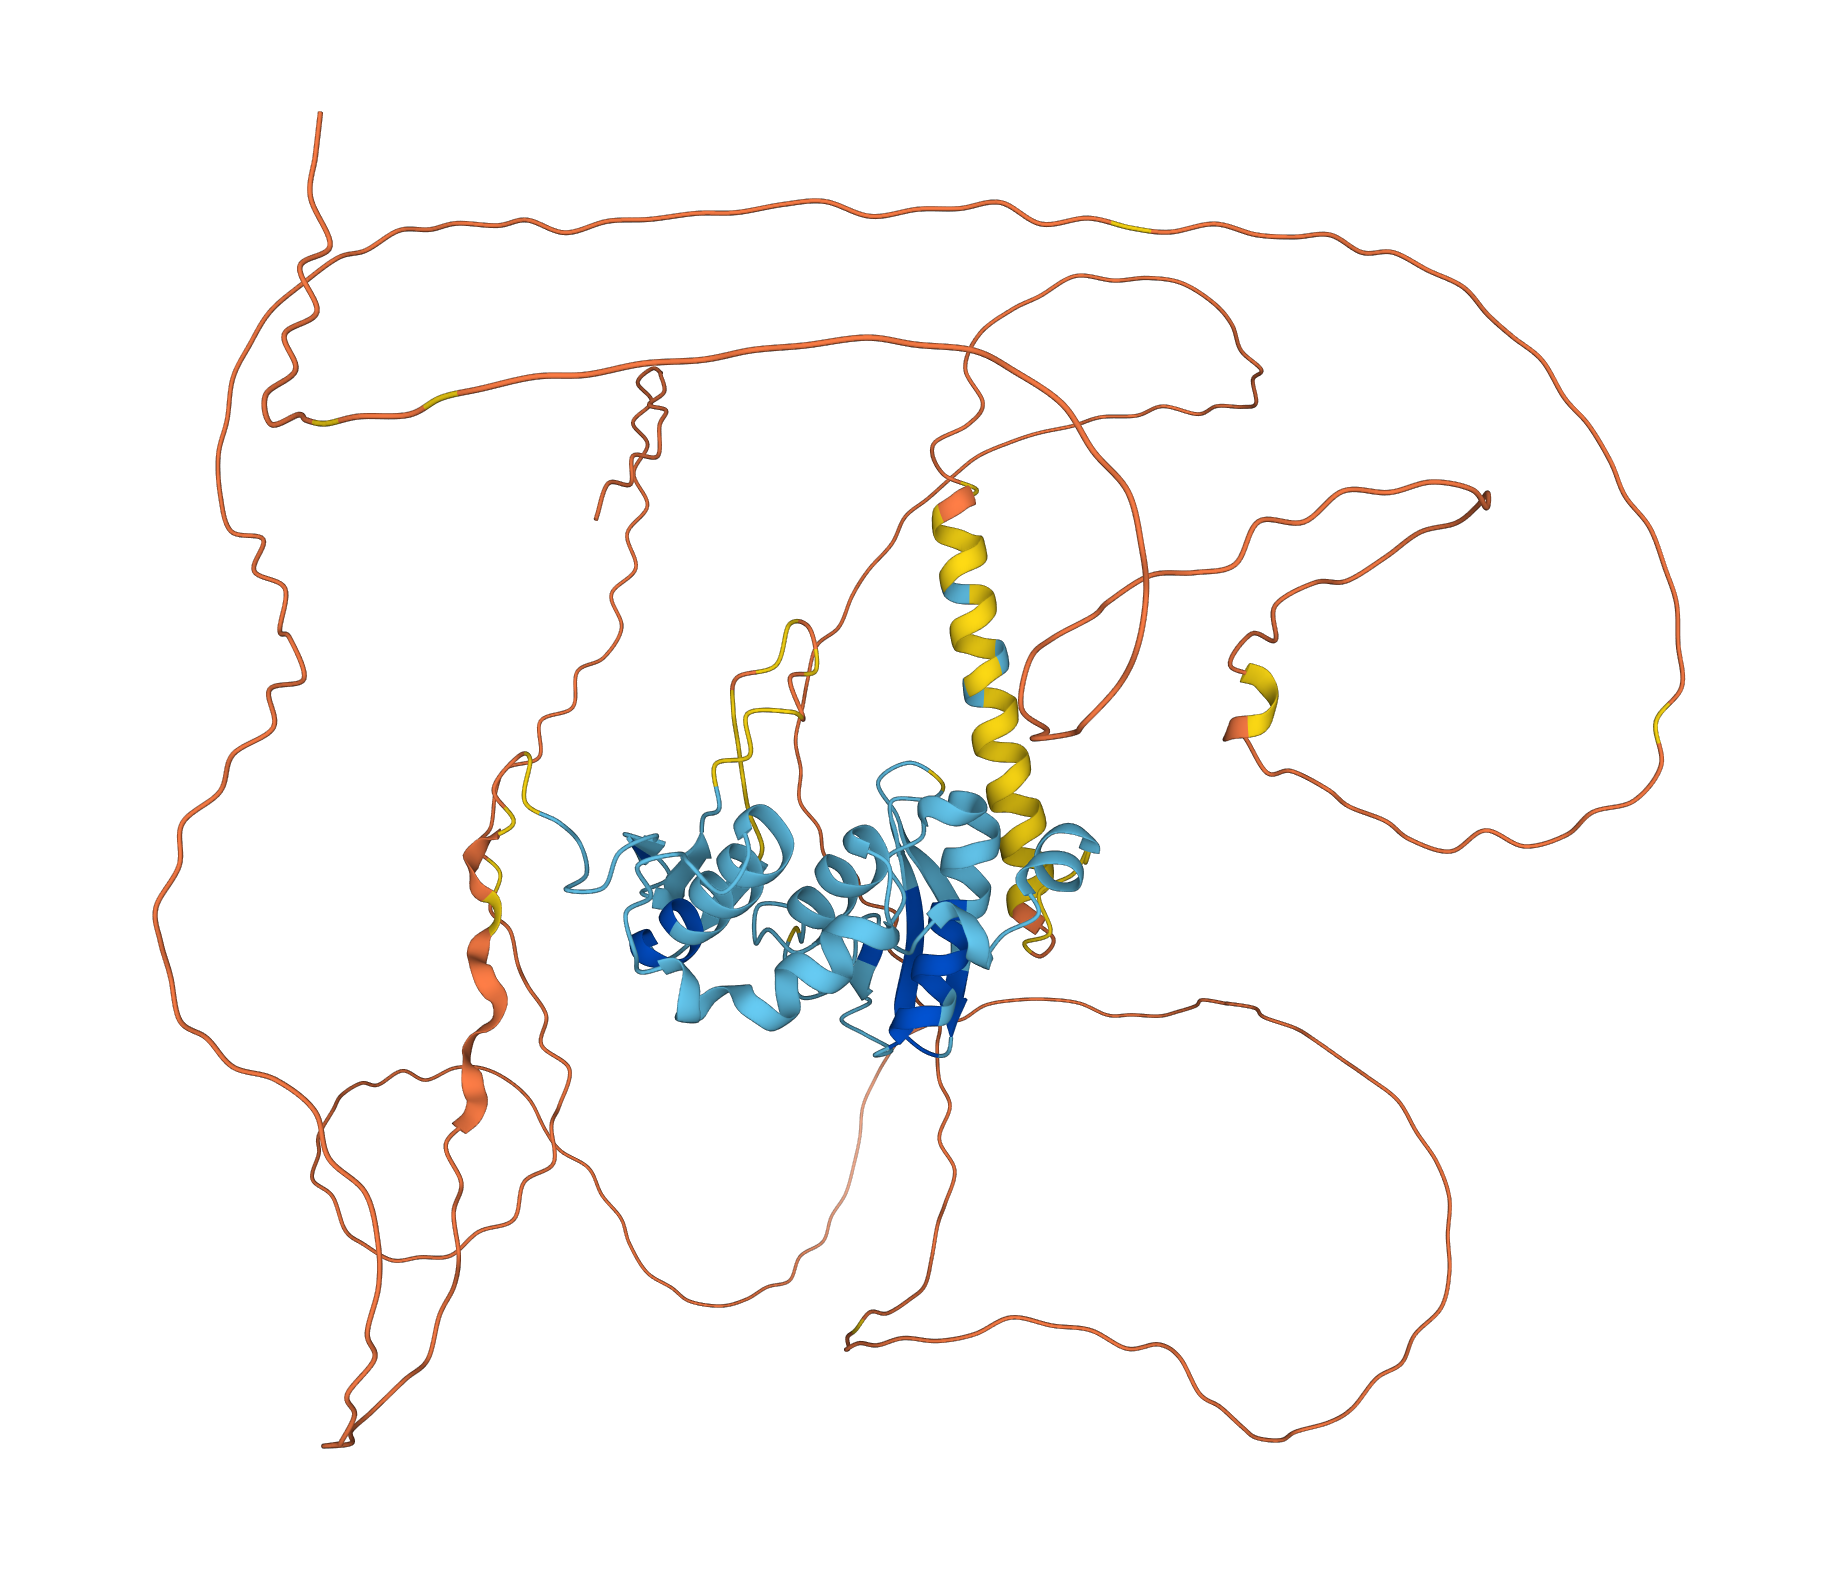
- 3D Structure:
- CsAP2-05
- Genome Databases:
- Tair
- Kegg
- External Resources
- GabiPD
- Gene Structure:
-

- Domain Architecture:
-

- Peptide Sequences
-
>CsAP2-05
MGSMNTNNWLSFPLSPTHASLPSHQFTLGLVNDNMDNPFQNQASEWNLMN
SHGSSSSNDQVPKVADFLGVSKSENQTDHLMPFNEIHHQASDSDYLFASN
SMVPADLMQQSVNLDNIHGSSSTYDFQENPSNLQSLTLSMGSGSKGSSVC
ETSSTDNVSTNNTTSTAVEPAAAAAAAAPRRTLDTFGQRTSIYRGVTRHR
WTGRYEAHLWDNSCRREGQSRKGRQVYLGGYDKEEKAARAYDMAALKYWG
TSTTTNFPISNYEKELEDMKNMTRQEFVASIRRKSSGFSRGASMYRGVTR
HHQHGRWQARIGRVAGNKDLYLGTFSTEEEAAEAYDIAAIKFRGLNAVTN
FDMNRYDVKSILESNTLPIGGGAAKRLKEAQALESSRKREEMMALTSTFA
HYGSAAAGAGSTSSSPLSSTMNNNSRLQAYPLLQPQTNSFIDHMTPHLTL
QNHDTSSPYHQDPNNSSLLHHQQNYIQTQLQLQQQQPGTSSYQFYNGYNN
NNNNNNNNGHNNNGNNNQFLQGFMENIGTTSSVMDNTGGNSYGGYGLDNT
AAATGSGTSAEELALVKVDYDMPSGGYGGWSAGSGSGSGNASNPGLFTMW
NDL
- CDS (Coding Sequence):
-
>CsAP2-05
ATGGGGTCAATGAATACAAACAACTGGCTTTCTTTTCCTCTATCTCCTAC
TCATGCTTCTCTACCATCACATCAATTCACTCTAGGGTTAGTCAATGATA
ACATGGACAACCCTTTTCAAAACCAAGCTTCAGAGTGGAATCTGATGAAT
AGCCACGGGAGTAGCAGTAGCAATGATCAAGTGCCCAAGGTGGCTGATTT
TCTTGGTGTTAGCAAATCTGAAAACCAAACAGATCATCTCATGCCCTTCA
ACGAAATTCATCACCAGGCCAGTGATTCTGACTACCTTTTTGCAAGTAAC
AGCATGGTCCCAGCAGACTTAATGCAGCAAAGTGTTAATTTGGATAATAT
TCATGGGTCTAGCTCTACCTATGACTTTCAAGAAAATCCAAGCAACCTTC
AGTCACTGACACTGTCGATGGGAAGTGGCAGCAAAGGTTCAAGTGTTTGT
GAAACCAGTAGCACTGATAATGTCAGTACTAATAATACCACCTCTACTGC
TGTGGAACCTGCAGCTGCAGCCGCTGCTGCTGCGCCTAGAAGGACCTTAG
ATACTTTCGGTCAAAGAACTTCAATTTATCGTGGTGTAACTAGGCATAGA
TGGACTGGAAGGTATGAAGCTCATCTTTGGGATAATAGTTGTAGAAGGGA
AGGGCAATCAAGGAAAGGAAGACAAGTTTATCTGGGCGGGTATGATAAAG
AAGAGAAAGCAGCTAGGGCTTACGATATGGCTGCACTCAAGTACTGGGGA
ACATCCACTACCACAAACTTTCCCATTAGTAACTACGAAAAGGAGTTGGA
GGATATGAAGAACATGACAAGACAAGAATTTGTGGCCTCTATTAGAAGAA
AGAGCAGTGGTTTTTCAAGAGGTGCATCAATGTATCGTGGAGTTACAAGA
CATCATCAACATGGAAGATGGCAAGCAAGGATTGGAAGAGTTGCTGGGAA
CAAAGATCTTTACTTAGGAACATTTAGTACGGAAGAAGAGGCTGCTGAAG
CATACGACATAGCAGCAATAAAATTCCGAGGGTTGAACGCAGTAACAAAC
TTTGACATGAATCGATACGACGTCAAAAGCATATTGGAAAGCAATACTCT
CCCAATCGGAGGTGGAGCCGCCAAGCGCCTCAAGGAGGCTCAAGCCTTGG
AGTCTTCAAGAAAACGTGAGGAAATGATGGCCCTAACCTCCACCTTCGCA
CATTACGGCTCAGCCGCAGCAGGAGCTGGCTCAACCAGCTCATCCCCATT
ATCATCAACAATGAATAATAATAGTCGTCTGCAGGCGTACCCACTGTTGC
AACCGCAGACAAACAGCTTCATCGATCACATGACCCCACACCTCACTCTC
CAAAACCACGATACGTCATCACCATATCATCAAGACCCAAATAATTCTTC
GTTGCTTCATCACCAGCAGAACTACATTCAGACTCAGCTTCAGTTGCAAC
AACAGCAGCCCGGAACGTCGTCGTATCAGTTTTACAATGGCTATAATAAT
AATAATAATAATAACAACAACAATGGCCACAATAATAACGGTAATAACAA
CCAGTTTCTTCAGGGGTTTATGGAGAATATTGGAACGACGTCTTCTGTTA
TGGACAACACTGGGGGCAACAGTTATGGCGGCTATGGTCTTGATAATACA
GCAGCGGCTACTGGCTCGGGGACTAGTGCGGAGGAGCTTGCTCTTGTGAA
GGTGGATTATGATATGCCTTCTGGCGGTTACGGAGGATGGTCCGCCGGTT
CTGGTTCGGGTTCGGGGAATGCCTCAAATCCGGGACTTTTTACTATGTGG
AATGACTTATAG - Nucleotide:
-
>CsAP2-05
ATGGGGTCAATGAATACAAACAACTGGCTTTCTTTTCCTCTATCTCCTAC
TCATGCTTCTCTACCATCACATCAATTCACTCTAGGGTTAGTCAATGATA
ACATGGACAACCCTTTTCAAAACCAAGCTTCAGGTACACATTTTGTACTA
ATGTAACTTTTCTCAACTACATATATTTGTGTGTGTATTAATTTATTTAT
ATACATGTACAGAGTGGAATCTGATGAATAGCCACGGGAGTAGCAGTAGC
AATGATCAAGTGCCCAAGGTGGCTGATTTTCTTGGTGTTAGCAAATCTGA
AAACCAAACAGATCATCTCATGCCCTTCAACGAAATTCATCACCAGGCCA
GTGATTCTGACTACCTTTTTGCAAGTAACAGCATGGTCCCAGCAGACTTA
ATGCAGCAAAGTGTTAATTTGGATAATATTCATGGGTCTAGCTCTACCTA
TGACTTTCAAGAAAATCCAAGCAACCTTCAGTCACTGACACTGTCGATGG
GAAGTGGCAGCAAAGGTTCAAGTGTTTGTGAAACCAGTAGCACTGATAAT
GTCAGTACTAATAATACCACCTCTACTGCTGTGGAACCTGCAGCTGCAGC
CGCTGCTGCTGCGCCTAGAAGGACCTTAGATACTTTCGGTCAAAGAACTT
CAATTTATCGTGGTGTAACTAGGTGAGTATTAGGGCTTTACTATAAATTA
TTACTGCAGAATGAAACCTTTTGTTTGTTTTGTACAATTATATAATGGCA
TAAATAGTTTTTCTCAATAATTTATTTTGTGAAAAATGAAGGCATAGATG
GACTGGAAGGTATGAAGCTCATCTTTGGGATAATAGTTGTAGAAGGGAAG
GGCAATCAAGGAAAGGAAGACAAGGTAAACTATATATGTATAATTCTATA
AAAGTTATTGATATAATAGATGTAAAAGCTCCTTATTAATTTTGTTATTT
TAGGGTTTTCATATTTTCTTCTACCCCTTGTTTTTCATTGTTGAAAGATC
ATGAATATATTTCTGACTATTTGTTTTTGTCAATATTGTATTCTTTTTCC
GCTCTCGGCCTGTCTTCATTGTCTCTTCAAGTTTATCTGGGTATGTAAAT
TACAATAAATCTTTTCCATTAACTGTGTTTAATTTTTCACTTAGTATATA
TATTTTTTGATACTTTCTTTTCGTAATTAAATTAATAGGCGGGTATGATA
AAGAAGAGAAAGCAGCTAGGGCTTACGATATGGCTGCACTCAAGTACTGG
GGAACATCCACTACCACAAACTTTCCCGTAATTAATGAGATACATTTAGT
AATTTTTACTGACTAATTATCTAATTGATCATAGATCGATTTTAATTTCA
TTCTTTTTAAACATGATTTTGCAGATTAGTAACTACGAAAAGGAGTTGGA
GGATATGAAGAACATGACAAGACAAGAATTTGTGGCCTCTATTAGAAGGT
AGTACAGATTTGTATATTAGCGCGAATTGATTAATTAATTGTAACAATAG
TTTGATTCTCACCATTTTATTTCCGATTTTGTTGAAAAATTTTAATTTTC
AGAAAGAGCAGTGGTTTTTCAAGAGGTGCATCAATGTATCGTGGAGTTAC
AAGGTATATACTAATCAGTAAAATGAATTACAGCAATGATTACAATGTAG
CACACGTAGATATATATAGCTCAATAACAATAAAAATATATTGGTTTTCC
TTGTATCATCAGACATCATCAACATGGAAGATGGCAAGCAAGGATTGGAA
GAGTTGCTGGGAACAAAGATCTTTACTTAGGAACATTTAGTAAGTAGTTA
GTATTTTTATTTTTACTTTTTTTTTTTTGCAAAGAAAGTAAGTAGTTAGA
ATACTTATATACTTCTTATTTAGGTACGGAAGAAGAGGCTGCTGAAGCAT
ACGACATAGCAGCAATAAAATTCCGAGGGTTGAACGCAGTAACAAACTTT
GACATGAATCGATACGACGTCAAAAGCATATTGGAAAGCAATACTCTCCC
AATCGGAGGTGGAGCCGCCAAGCGCCTCAAGGAGGCTCAAGCCTTGGAGT
CTTCAAGAAAACGTGAGGAAATGATGGCCCTAACCTCCACCTTCGCACAT
TACGGCTCAGCCGCAGCAGGAGCTGGCTCAACCAGCTCATCCCCATTATC
ATCAACAATGAATAATAATAGTCGTCTGCAGGCGTACCCACTGTTGCAAC
CGCAGACAAACAGCTTCATCGATCACATGACCCCACACCTCACTCTCCAA
AACCACGATACGTCATCACCATATCATCAAGACCCAAATAATTCTTCGTT
GCTTCATCACCAGCAGAACTACATTCAGACTCAGCTTCAGTTGCAACAAC
AGCAGCCCGGAACGTCGTCGTATCAGTTTTACAATGGCTATAATAATAAT
AATAATAATAACAACAACAATGGCCACAATAATAACGGTAATAACAACCA
GTTTCTTCAGGGGTTTATGGAGAATATTGGAACGACGTCTTCTGTTATGG
ACAACACTGGGGGCAACAGTTATGGCGGCTATGGTCTTGATAATACAGCA
GCGGCTACTGGCTCGGGGACTAGTGCGGAGGAGCTTGCTCTTGTGAAGGT
GGATTATGATATGCCTTCTGGCGGTTACGGAGGATGGTCCGCCGGTTCTG
GTTCGGGTTCGGGGAATGCCTCAAATCCGGGACTTTTTACTATGTGGAAT
GACTTATAG