View Summary Pdf File Gene model: Cs_Cb2.01g049970.m01
IDENTIFICATION
- Species Name
- AP2
- Locus:
- Cs_Cb2.01g049970.m01
- Gene Model:
- Cs_Cb2.01g049970.m01
- Description:
- CsAP2-01
- Family:
- AP2
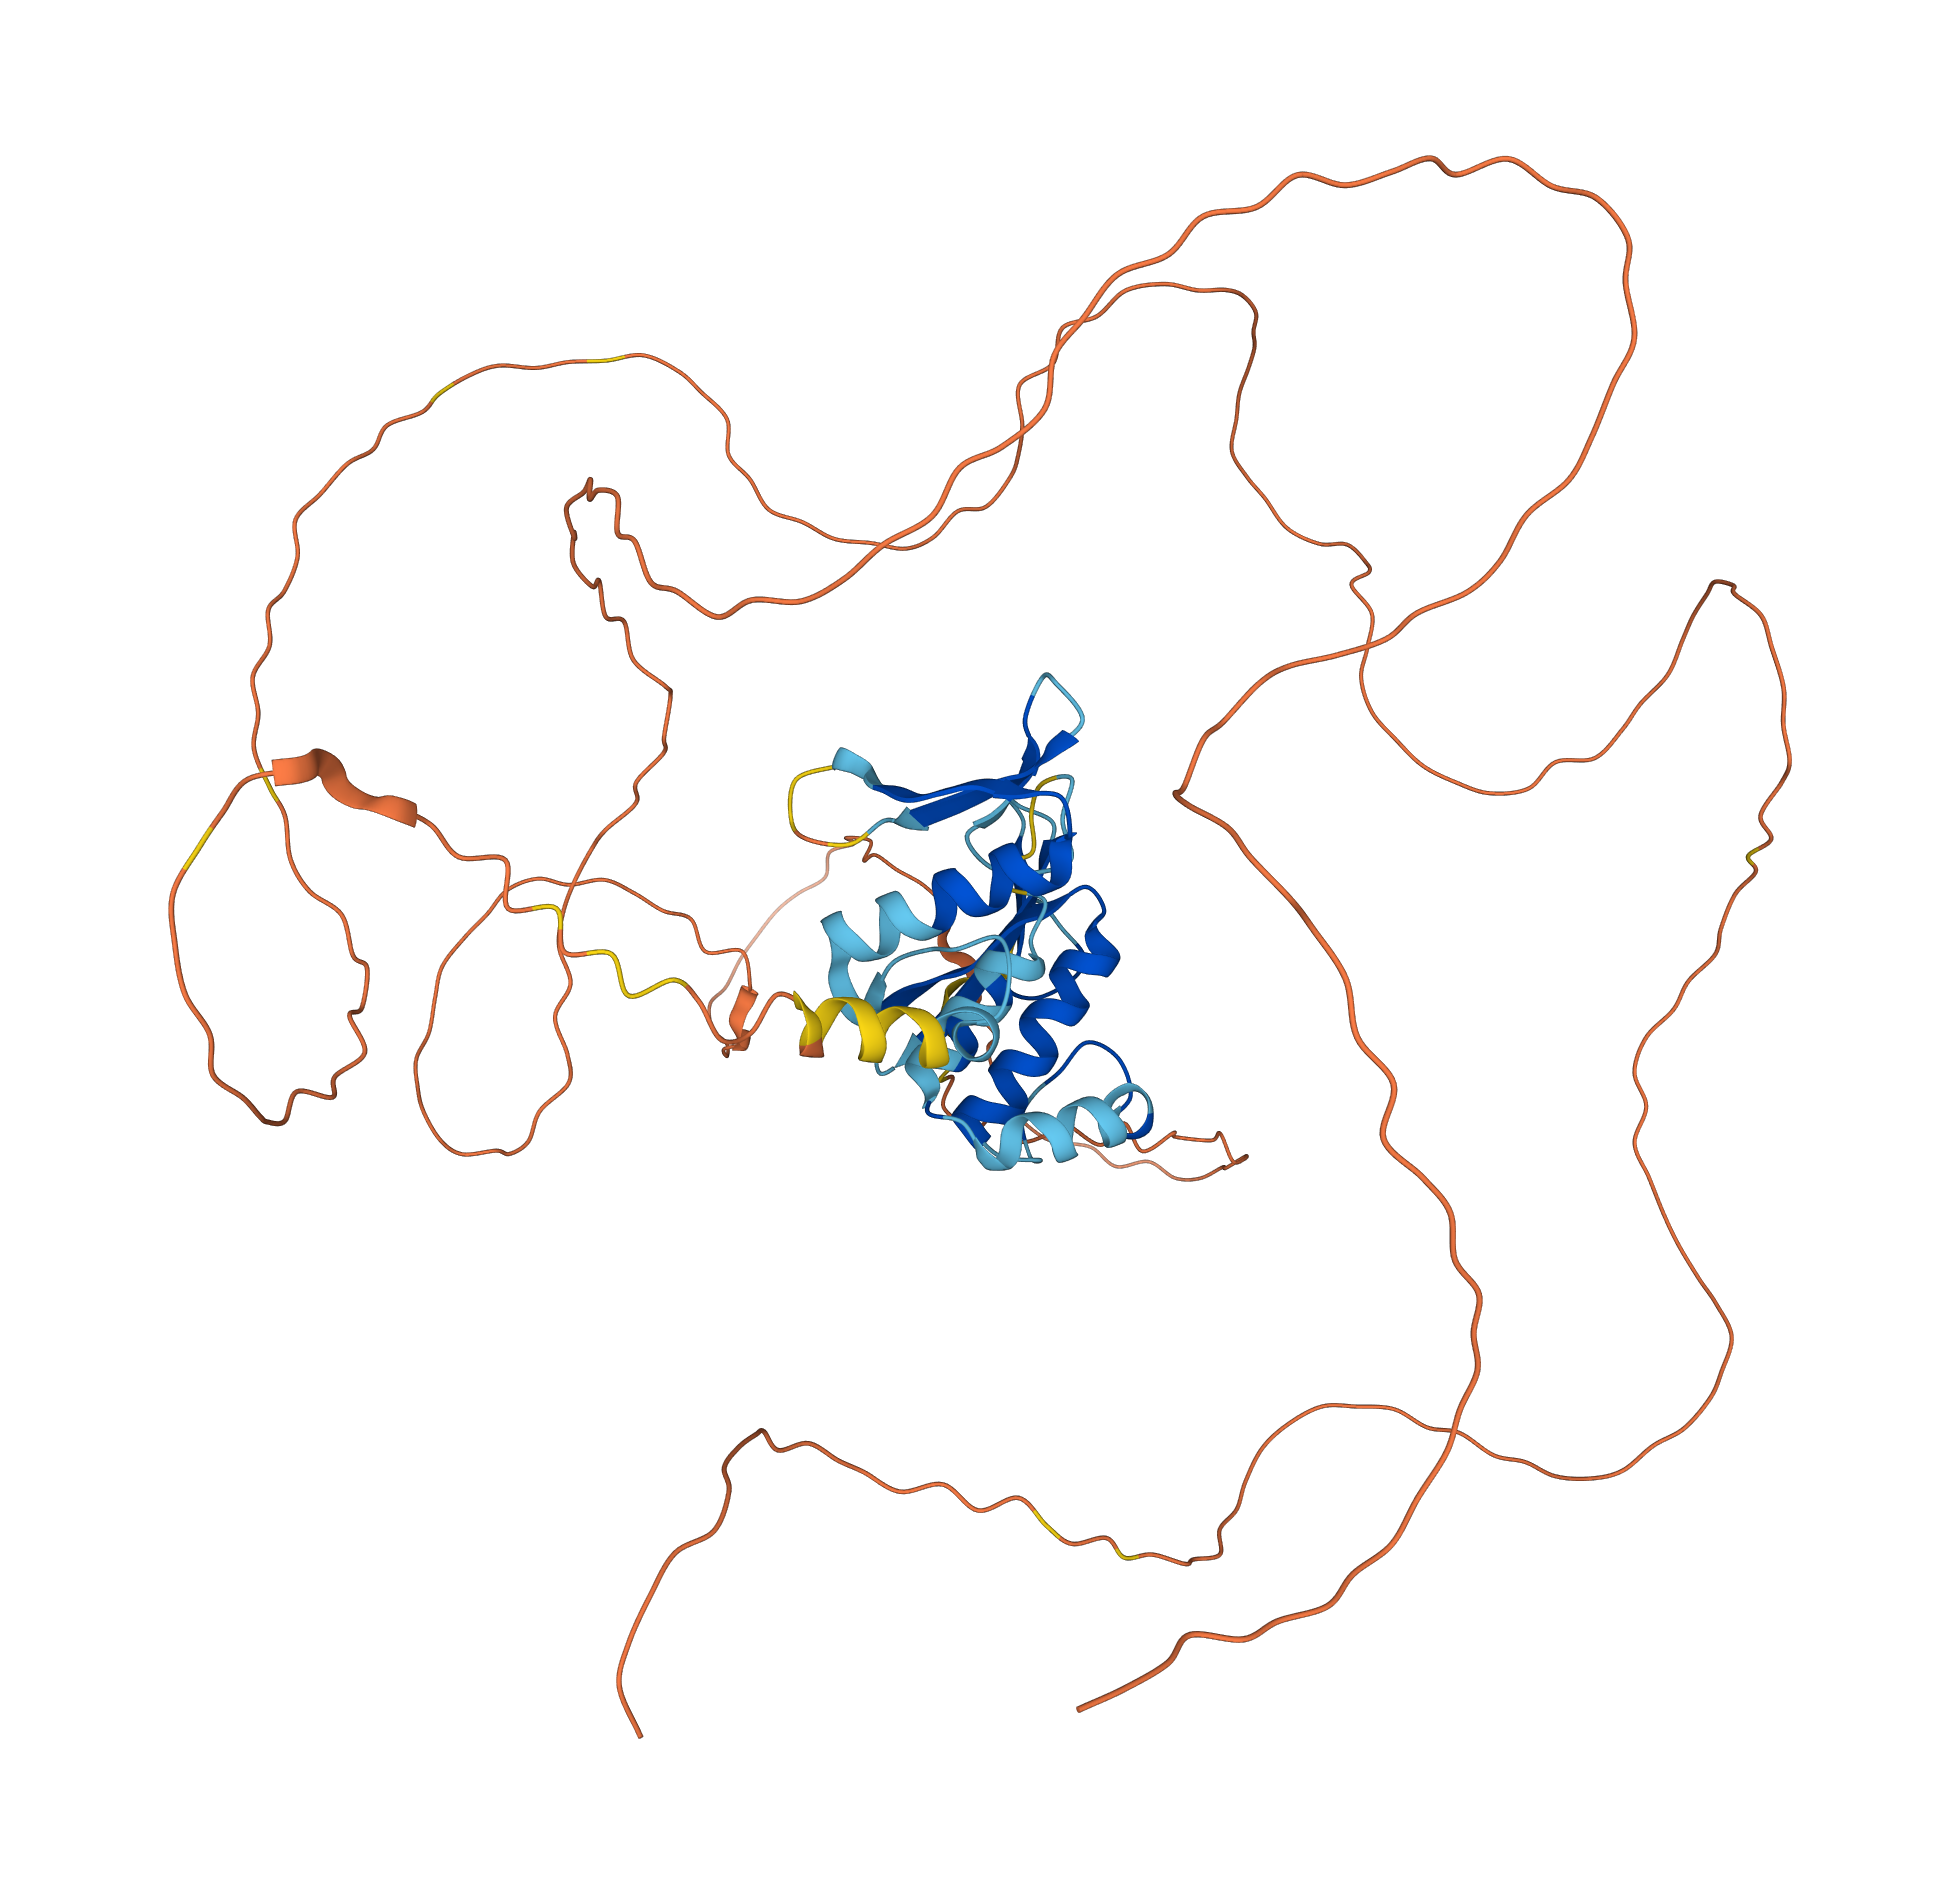
- 3D Structure:
- CsAP2-01
- Genome Databases:
- Tair
- Kegg
- External Resources
- GabiPD
- Gene Structure:
-

- Domain Architecture:
-

- Peptide Sequences
-
>CsAP2-01
MMLDLNVNINNGADSTYEKTKERGAELMIMEVEEKGSTTQIMEDSGSSGS
SVVNVEIDALSSTTTITTSNGVFREQDSSINVTNTTSSTFFFDIMKREKD
CNNGATAGKETNNISPPGFLTRSFFPVAGEKVGNQFVEAGSGSSSSRPQW
LNLSFADSGGGGAAVQPPADVKVLQQKQQIKKSRRGPRSRSSQYRGVTFY
RRTGRWESHIWDCGKQVYLGGFDTAHAAARAYDRAAIKFRGVDADINFNV
TDYDEDMMQMKNLSKEEFVQILRRQSTGFSRGSSKYRGVTLHKCGRWEAR
MGQFLGKKAYDKAAIKCNGRDAITNFEHSTYQGEIILDTNAQGNDHNLDL
NLGISPPCDGPKGREYSFGLGDTRVHWNPREGPHRIRPIMIEGQSSPHIL
PPNHAASATCSGVYPAFLPKHE
- CDS (Coding Sequence):
-
>CsAP2-01
ATGATGTTGGATCTTAATGTTAATATCAACAACGGTGCCGATTCAACCTA
CGAGAAGACTAAGGAAAGAGGAGCAGAGTTGATGATAATGGAGGTAGAAG
AGAAAGGTTCCACAACCCAAATAATGGAAGATTCTGGTTCCTCTGGTTCT
TCGGTTGTTAATGTTGAAATCGATGCTCTGAGTAGTACTACAACTATTAC
TACCTCTAATGGCGTCTTTAGAGAACAAGACTCTTCCATCAATGTCACGA
ACACAACATCTTCGACATTTTTCTTTGACATAATGAAGAGAGAAAAGGAC
TGTAACAACGGTGCCACTGCCGGGAAAGAAACTAATAACATCTCTCCGCC
GGGATTTCTAACCAGGTCTTTTTTCCCGGTGGCCGGAGAAAAGGTAGGGA
ATCAGTTCGTTGAAGCCGGTTCTGGGTCGTCTTCCTCGCGACCTCAGTGG
TTAAACTTATCTTTTGCGGATTCCGGTGGAGGAGGTGCCGCCGTCCAACC
GCCGGCGGATGTTAAAGTTTTGCAGCAGAAACAACAGATAAAGAAAAGCC
GGCGGGGACCAAGGTCCCGGAGCTCTCAGTACCGTGGCGTTACGTTTTAC
CGGAGAACCGGCCGGTGGGAATCCCATATTTGGGATTGTGGGAAGCAAGT
ATATTTAGGTGGATTCGACACAGCTCATGCTGCTGCCAGAGCTTACGATC
GAGCTGCAATCAAGTTTCGTGGAGTTGATGCTGATATCAATTTCAATGTA
ACCGATTACGATGAAGATATGATGCAGATGAAAAACCTGAGCAAAGAAGA
ATTTGTTCAAATACTTCGACGACAAAGCACTGGATTTTCTCGTGGGAGCT
CAAAATATAGAGGAGTAACTTTGCATAAATGTGGTCGATGGGAAGCTCGA
ATGGGACAATTCCTTGGAAAAAAGGCTTATGACAAAGCAGCCATCAAATG
TAATGGAAGGGATGCAATTACCAACTTTGAGCATAGTACTTATCAGGGTG
AGATAATTTTAGACACCAATGCACAAGGCAATGACCACAACCTTGATCTG
AACTTGGGAATTTCTCCACCATGTGATGGTCCAAAAGGGCGTGAGTACTC
TTTTGGTCTTGGGGATACTCGTGTTCATTGGAACCCTCGTGAAGGACCTC
ACAGAATAAGACCGATAATGATTGAAGGGCAGTCATCCCCACATATTCTA
CCTCCCAACCATGCTGCTTCAGCTACATGTTCAGGAGTGTATCCAGCCTT
CTTACCAAAACATGAG
- Nucleotide:
-
>CsAP2-01
ATGATGTTGGATCTTAATGTTAATATCAACAACGGTGCCGATTCAACCTA
CGAGAAGACTAAGGAAAGAGGAGCAGAGTTGATGATAATGGAGGTAGAAG
AGAAAGGTTCCACAACCCAAATAATGGAAGATTCTGGTTCCTCTGGTTCT
TCGGTTGTTAATGTTGAAATCGATGCTCTGAGTAGTACTACAACTATTAC
TACCTCTAATGGCGTCTTTAGAGAACAAGACTCTTCCATCAATGTCACGA
ACACAACATCTTCGACATTTTTCTTTGACATAATGAAGAGAGAAAAGGAC
TGTAACAACGGTGCCACTGCCGGGAAAGAAACTAATAACATCTCTCCGCC
GGGATTTCTAACCAGGTCTTTTTTCCCGGTGGCCGGAGAAAAGGTAGGGA
ATCAGTTCGTTGAAGCCGGTTCTGGGTCGTCTTCCTCGCGACCTCAGTGG
TTAAACTTATCTTTTGCGGATTCCGGTGGAGGAGGTGCCGCCGTCCAACC
GCCGGCGGATGTTAAAGTTTTGCAGCAGAAACAACAGATAAAGAAAAGCC
GGCGGGGACCAAGGTCCCGGAGCTCTCAGTACCGTGGCGTTACGTTTTAC
CGGAGAACCGGCCGGTGGGAATCCCATATTTGGTGAGTTTGTTTCCATGG
AAAATCAACAAACATGTATATATATATATAAAATATAATATATAATTATA
TTATATTTACTAACTTCATTTTTCTTCTTCTTTACTTTTTGGAATACTTA
GGGATTGTGGGAAGCAAGTATATTTAGGTACGTAATTTTGCTAATTATTA
GTTTCTTTTTAATTATAATGTAACTAATTTCATGGCAAGAAGATTTTTGT
TGATTTGTTTGTTTTTTGTTTATTCATTTATTTTATTTATTTTAGGTGGA
TTCGACACAGCTCATGCTGCTGCCAGGTATGCTTAATTATTTACCTTTTT
TGTCTTTTTTTTTTCTGATAAAAAAATAAATATTTGTGTAAAATATACAT
ATATTATTTATGTGTGTATATAATGTTAGCTAAATTGGGTTATTGATATT
TTTTCTAACTTCAGAGCTTACGATCGAGCTGCAATCAAGTTTCGTGGAGT
TGATGCTGATATCAATTTCAATGTAACCGATTACGATGAAGATATGATGC
AGGTGCCACATATAAATAAATATGTATAGTATATGATTTATATTTGTTTA
TAGTTAAAGTTTTGTATTAACAATTTCTCTAATTTTGAAAATTTTTGCTC
TTATTTGAGATGAAAAACCTGAGCAAAGAAGAATTTGTTCAAATACTTCG
ACGACAAAGCACTGGATTTTCTCGTGGGAGCTCAAAATATAGAGGAGTAA
CTTTGCATAAATGTGGTCGATGGGAAGCTCGAATGGGACAATTCCTTGGA
AAAAAGTGAGAACCATTTCTCATCTAATTACACAATTATGTATTATTATG
AGAGTCAAAACATTGAGAAAGTTGGTAGTCATCACATATGTGGTTGATGG
TAGTGTTATGCATACAAAAGAAGAAATGCCTTAATGGGCACTCCACTTTT
GTATCTATAAAATCATGATCCTTCTTTGCAGGTATATTTATCTTGGATTA
TTCGACAGCGAACTAGAGGCTGCAAGGTCCTCATTTGTTCATGAATATAT
TTGAAGAATTCAATATTGTCCTCTAATATTGACAACATTTTCTTTTTAAC
TCGATAGAATAAAACACATTATGCCTTTGGCTTGGCTTTTGTTTGGTGGG
GATTTAATCCAACACAAGTTTTTTCCTTTATCTTTGTTTAAATTCAGGGC
TTATGACAAAGCAGCCATCAAATGTAATGGAAGGGATGCAATTACCAACT
TTGAGCATAGTACTTATCAGGGTGAGATAATTTTAGACACCAATGCACAA
GGTACTAAATTTAATGACTTTATAGCTAAAGGAGTTATTATCTAGTACTA
CAAATATAACAATTAATTCTTCTGTTGCAAAAATGCAGGCAATGACCACA
ACCTTGATCTGAACTTGGGAATTTCTCCACCATGTGATGGTCCAAAAGGG
CGTGAGTACTCTTTTGGTCTTGGGGATACTCGTGTTCATTGGAACCCTCG
TGAAGGACCTCACAGAATAAGACCGATAATGGTACATTGATTTTAATAAT
AGGCTCAGTTTAGAAAGTGCAGTTTTCTCTCCTTTCTGATATAAAAACTA
AAATTAGTATCCACTACTCTCAACAGATTGAAGGGCAGTCATCCCCACAT
ATTCTACCTCCCAACCATGCTGCTTCAGCTACATGTTCAGGAGTGTATCC
AGCCTTCTTACCAAAACATGAG