View Summary Pdf File Gene model: Cs_Cb2.10g040140.m01
IDENTIFICATION
- Species Name
- ZF-HD
- Locus:
- Cs_Cb2.10g040140.m01
- Gene Model:
- Cs_Cb2.10g040140.m01
- Description:
- CsZFHD-10
- Family:
- ZFHD
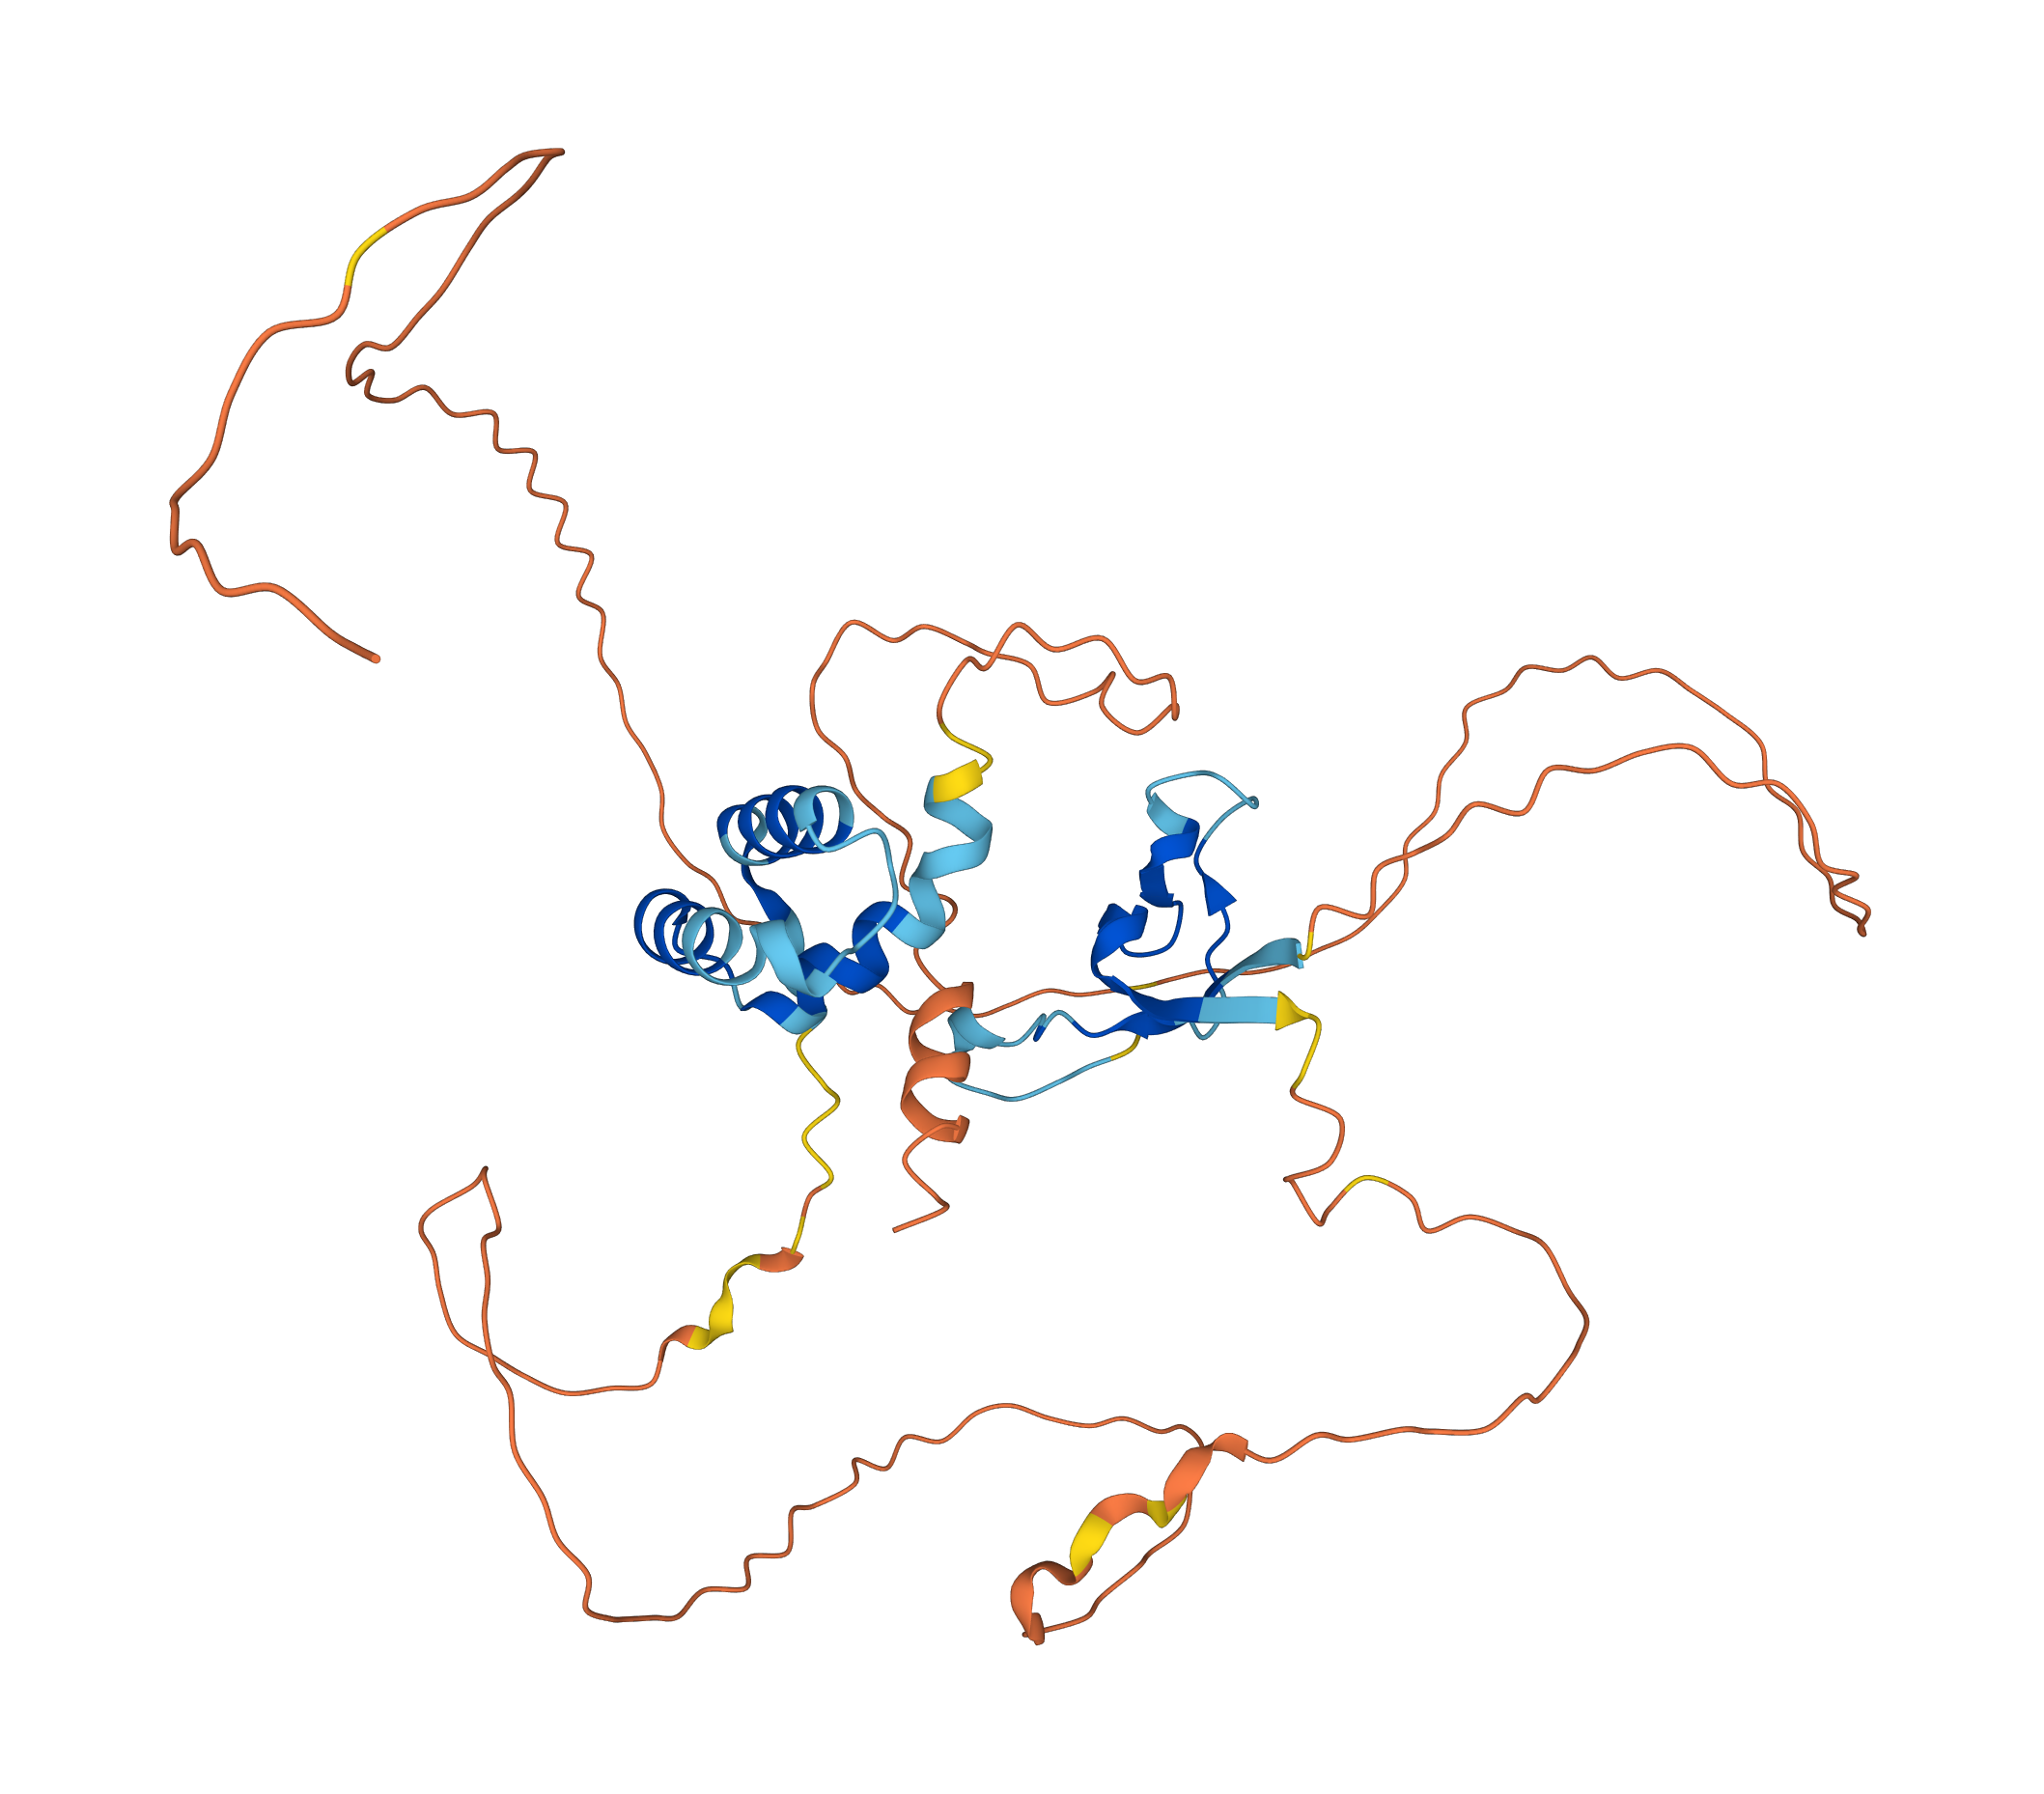
- 3D Structure:
- CsZFHD-10
- Genome Databases:
- Tair
- Kegg
- External Resources
- GabiPD
- Gene Structure:
-
- Domain Architecture:
-
- Peptide Sequences
-
>CsZFHD-10
MEFRAQDNEMRTSPAGTLTYNTHVSKEGGGGERRSRSVNNNHNHNHNGST
NTMSCTNQTLDTNYPPRLSFHNQTGQLHGSRDPDPDRVTTLPITTTFSPS
GASANKSSSKTTSSSAIRYRECLKNHAASTGGNIYDGCGEFMPSGEEGSL
EALKCAACQCHRNFHRKEIDGESQLYSPSSRRSSSTNATTLMLNALQLPP
PLPSPSGFHHHHHHHKYFNHGAPQIIQPMNVAFGGGGAAGTESSSEDLNL
YGSTAEAAAAAAAAPPPFGSKKRFRTKFTQEQKDKMLEFSEKVGWRFQKQ
NEEEVERFCAEVGIRRQLALSLVMIRLRMGVRGGH
- CDS (Coding Sequence):
-
>CsZFHD-10
ATGGAATTTAGAGCTCAAGATAACGAGATGAGGACGTCACCAGCTGGGAC
ATTGACATATAATACCCATGTGAGTAAAGAAGGAGGAGGAGGAGAAAGAA
GATCAAGATCGGTTAATAATAATCATAATCATAATCATAATGGTTCTACA
AACACTATGAGTTGCACTAATCAAACCCTAGACACTAACTACCCACCTCG
CTTAAGTTTCCATAACCAAACCGGCCAGCTTCATGGGTCTAGAGATCCGG
ACCCAGATCGGGTTACCACCTTGCCCATAACGACGACGTTTTCGCCTTCG
GGAGCTTCAGCCAATAAGTCTTCCTCCAAAACCACATCATCCTCCGCTAT
CAGGTACAGAGAATGCCTTAAGAACCACGCGGCCAGCACCGGCGGCAACA
TCTACGATGGCTGCGGTGAGTTCATGCCAAGTGGCGAAGAAGGATCTCTG
GAAGCTCTCAAATGCGCTGCTTGTCAGTGCCACCGGAATTTTCACCGGAA
AGAGATCGACGGTGAGTCTCAATTATACAGTCCGAGCTCAAGAAGATCGT
CAAGTACAAATGCTACTACTCTGATGCTGAATGCTCTACAACTCCCTCCA
CCATTGCCATCTCCATCTGGGTTTCATCACCATCACCATCACCACAAGTA
TTTCAACCACGGCGCCCCTCAGATTATTCAGCCGATGAATGTTGCTTTCG
GTGGTGGCGGAGCAGCAGGTACCGAATCTTCGAGCGAAGATCTTAATCTT
TACGGATCCACCGCCGAGGCTGCTGCTGCTGCAGCGGCGGCACCGCCTCC
TTTCGGGTCAAAGAAGCGGTTCAGGACAAAGTTCACGCAGGAGCAGAAAG
ATAAGATGCTGGAGTTCTCAGAGAAAGTTGGGTGGAGGTTTCAAAAGCAG
AACGAGGAAGAGGTTGAGAGGTTTTGTGCTGAGGTTGGAATTAGACGACA
GCTAGCTCTCTCCTTGGTGATGATCAGGTTACGTATGGGTGTTAGAGGAG
GGCATTAA - Nucleotide:
-
>CsZFHD-10
ATGGAATTTAGAGCTCAAGATAACGAGATGAGGACGTCACCAGCTGGGAC
ATTGACATATAATACCCATGTGAGTAAAGAAGGAGGAGGAGGAGAAAGAA
GATCAAGATCGGTTAATAATAATCATAATCATAATCATAATGGTTCTACA
AACACTATGAGTTGCACTAATCAAACCCTAGACACTAACTACCCACCTCG
CTTAAGTTTCCATAACCAAACCGGCCAGCTTCATGGGTCTAGAGATCCGG
ACCCAGATCGGGTTACCACCTTGCCCATAACGACGACGTTTTCGCCTTCG
GGAGCTTCAGCCAATAAGTCTTCCTCCAAAACCACATCATCCTCCGCTAT
CAGGTACAGAGAATGCCTTAAGAACCACGCGGCCAGCACCGGCGGCAACA
TCTACGATGGCTGCGGTGAGTTCATGCCAAGTGGCGAAGAAGGATCTCTG
GAAGCTCTCAAATGCGCTGCTTGTCAGTGCCACCGGAATTTTCACCGGAA
AGAGATCGACGGTGAGTCTCAATTATACAGTCCGAGCTCAAGAAGATCGT
CAAGTACAAATGCTACTACTCTGATGCTGAATGCTCTACAACTCCCTCCA
CCATTGCCATCTCCATCTGGGTTTCATCACCATCACCATCACCACAAGTA
TTTCAACCACGGCGCCCCTCAGATTATTCAGCCGATGAATGTTGCTTTCG
GTGGTGGCGGAGCAGCAGGTACCGAATCTTCGAGCGAAGATCTTAATCTT
TACGGATCCACCGCCGAGGCTGCTGCTGCTGCAGCGGCGGCACCGCCTCC
TTTCGGGTCAAAGAAGCGGTTCAGGACAAAGTTCACGCAGGAGCAGAAAG
ATAAGATGCTGGAGTTCTCAGAGAAAGTTGGGTGGAGGTTTCAAAAGCAG
AACGAGGAAGAGGTTGAGAGGTTTTGTGCTGAGGTTGGAATTAGACGACA
GGTTCTCAAGGTTTGGATGCATAATAACAAGAGCACTATGATGAAGACTA
AGCCTAACAATATTAATAATAATAATAATCAAGACATGAATAGAGTAGTA
CTGATGAACGATGATAATAACATGGTCGCCTCCAATCATCATCAGTCATC
TATTGATGAGGTAAGTCATAATCATGATGATGAACCAGTCCTTGATCAGG
AAGAAGTATTAGATACTTAGATTATATCATATTATTACCTAATTTATATA
TATATATATTATTATTATTTAACTATCTTTTTTTTTTTCTCTTTTTTAAT
TATGTGTAAGAGCTAGCTCTCTCCTTGGTGATGATCAGGTTACGTATGGG
TGTTAGAGGAGGGCATTAA