View Summary Pdf File Gene model: Cs_Cb2.08g363980.m01
IDENTIFICATION
- Species Name
- ZF-HD
- Locus:
- Cs_Cb2.08g363980.m01
- Gene Model:
- Cs_Cb2.08g363980.m01
- Description:
- CsZFHD-09
- Family:
- ZFHD
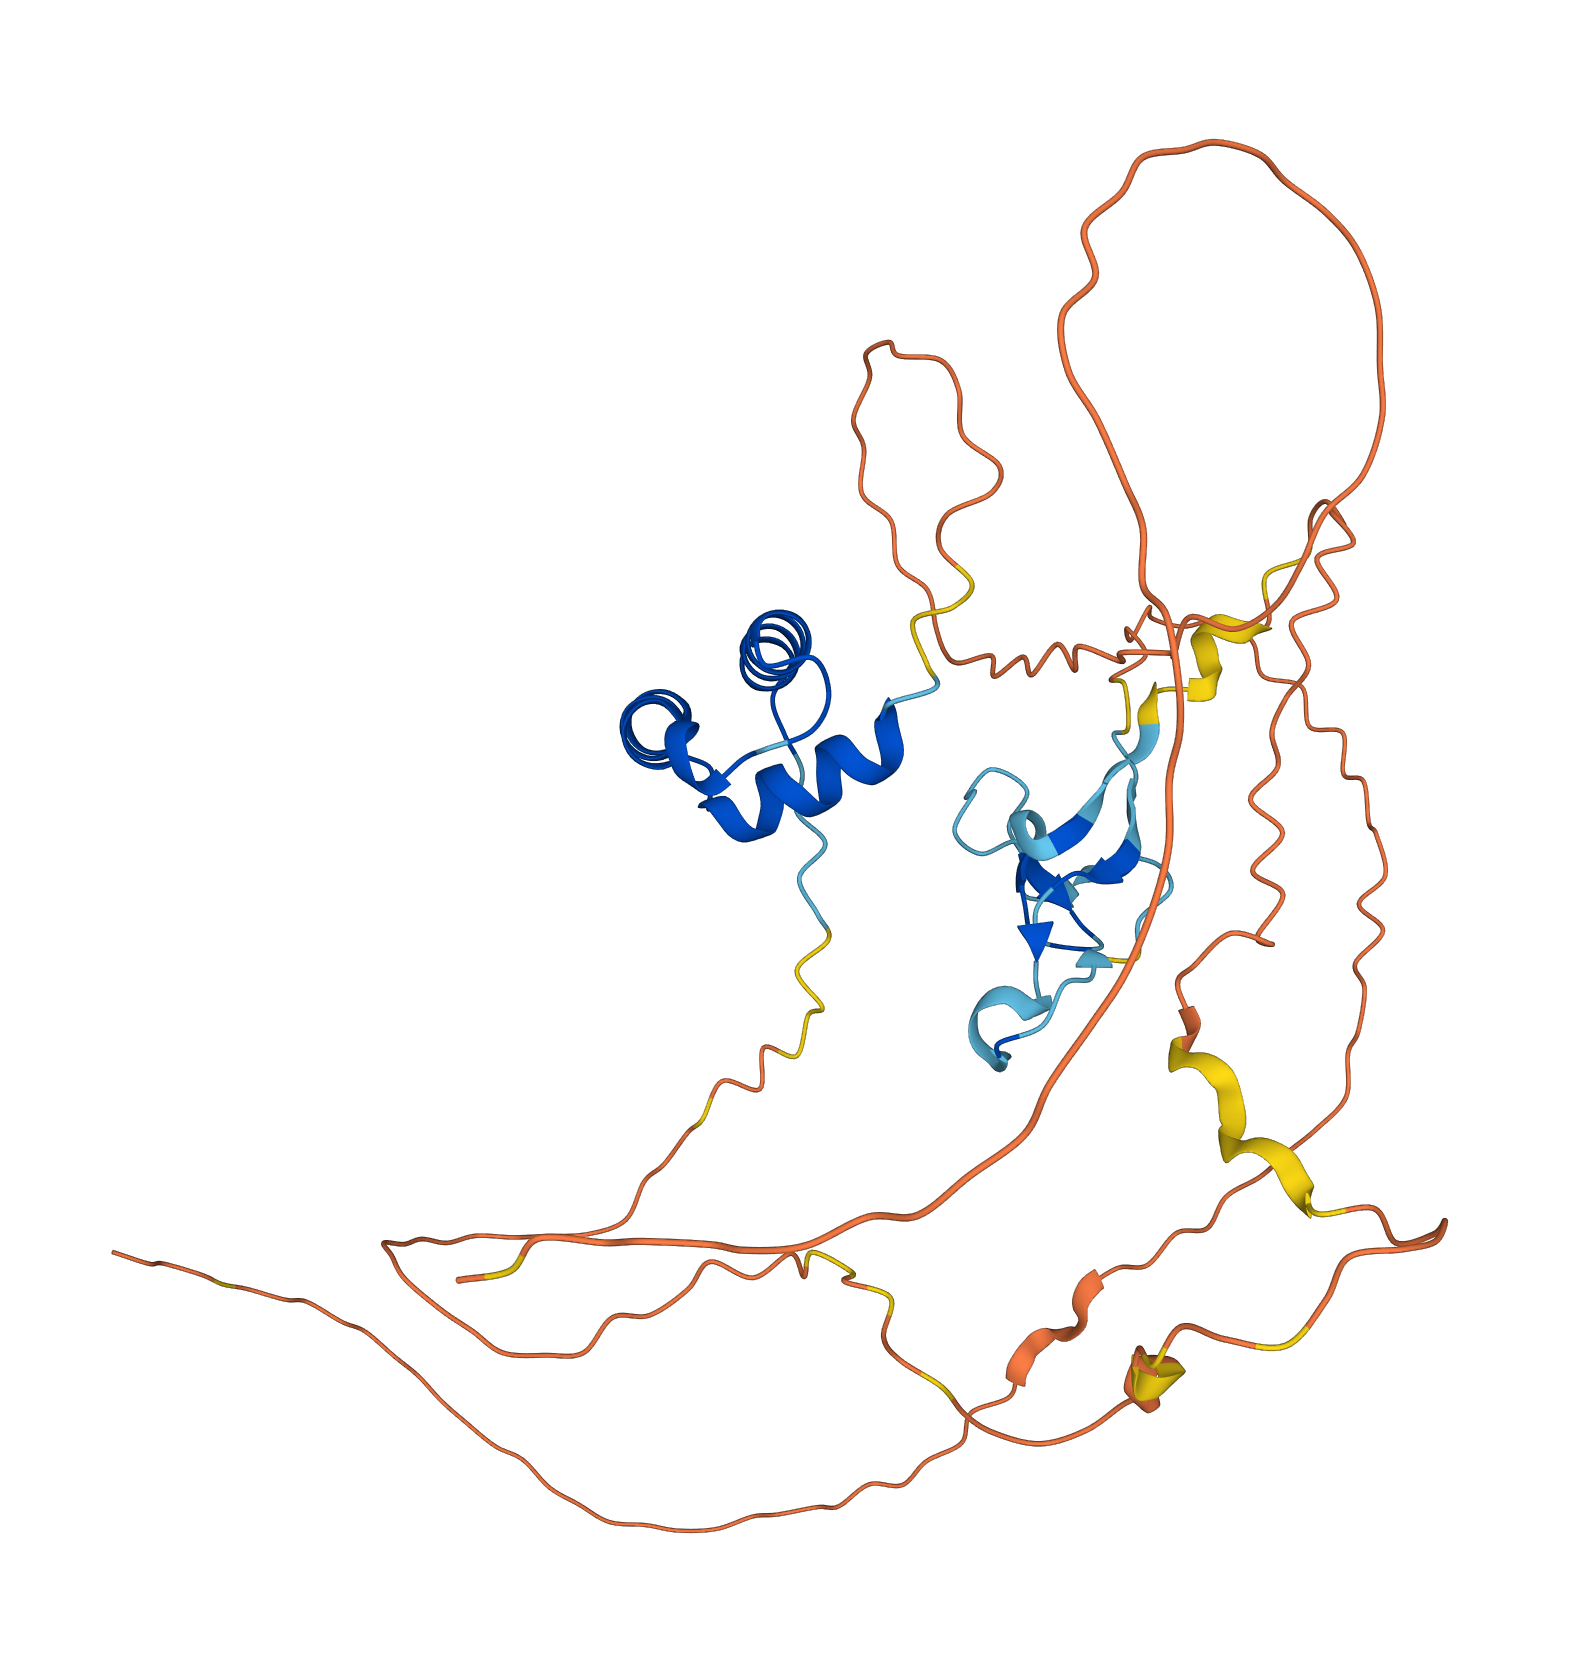
- 3D Structure:
- CsZFHD-09
- Genome Databases:
- Tair
- Kegg
- External Resources
- GabiPD
- Gene Structure:
-
- Domain Architecture:
-
- Peptide Sequences
-
>CsZFHD-09
MLLTLVVRNPPEAESETPTRIQPIKPISISNGVLKRHNPHHHHHHHHHLP
APAAVSSPTAVVSYRECLKNHAATLGGHALDGCGEYMPSPTAISTDPTSL
KCAACGCHRNYHRREPDEQALLLPHHHHPTTTTTHVIEYQPHHRHHPPPP
PQPHHGGGNRSPNSASPPPISSSYYPSAPHMLLALSTGLSGPGGAQENAG
VVGGGGGMITPNSNSSRKRFRTKFSQEQKEKMYEFAERVGWKMQKRDEDI
VMEFCNDVGVDKGVLKVWMHNNKNTLGKKDINGGGASTGGRSNNNNNNTN
LNLLEQNHNNGGSSNKTNSENDNNNNNNVQNLNHYKDDDDDGGVHVATNG
SSSTS
- CDS (Coding Sequence):
-
>CsZFHD-09
ATGCTACTAACACTGGTAGTACGAAATCCACCAGAAGCCGAGAGCGAAAC
TCCGACAAGGATCCAACCCATTAAGCCAATCTCCATTAGTAACGGTGTAC
TCAAACGCCACAACCCACATCACCACCATCACCACCACCACCACTTACCG
GCGCCGGCCGCAGTATCATCTCCAACAGCAGTTGTTTCGTACAGAGAATG
TCTCAAAAACCACGCCGCCACTTTGGGTGGTCATGCCCTAGATGGCTGCG
GCGAGTACATGCCTTCACCTACAGCTATATCAACAGACCCAACATCGCTA
AAATGCGCCGCCTGTGGTTGCCACCGAAATTATCATCGCCGGGAGCCAGA
TGAGCAAGCTTTATTGTTACCTCATCATCATCATCCAACAACAACAACAA
CCCATGTCATCGAGTACCAGCCTCACCATCGTCACCATCCTCCTCCACCA
CCTCAGCCACACCACGGCGGTGGAAATCGAAGCCCCAATTCGGCTTCTCC
TCCGCCGATCTCATCTTCTTACTACCCATCTGCACCTCACATGCTGTTAG
CTCTATCGACCGGGCTATCGGGTCCGGGCGGAGCCCAAGAGAACGCGGGT
GTCGTCGGCGGTGGCGGTGGGATGATCACACCGAACTCTAATAGTTCCCG
TAAAAGGTTCAGAACTAAGTTCAGTCAAGAACAGAAAGAGAAGATGTACG
AATTCGCTGAGCGAGTTGGTTGGAAGATGCAGAAGAGAGATGAAGACATT
GTTATGGAGTTTTGTAATGATGTTGGTGTTGATAAAGGGGTTCTTAAAGT
CTGGATGCATAATAACAAGAACACACTTGGGAAAAAAGATATTAATGGCG
GAGGAGCCAGTACAGGTGGAAGAAGCAACAACAACAACAACAATACTAAT
CTTAATCTTCTTGAGCAAAACCATAACAATGGCGGTAGCAGCAACAAAAC
CAACAGTGAGAACGACAACAACAACAACAACAATGTTCAGAATCTCAACC
ATTATAAAGATGATGATGATGATGGTGGAGTTCATGTAGCAACTAATGGT
TCATCTTCTACTTCTTGA - Nucleotide:
-
>CsZFHD-09
ATGGTGATGACTGATCATATTTATAATCTACACAAACATCTAATAATTCT
AACATACCCATAAAAAAGCAGAGAAGACCCCTCTTCTTCTTTCTCTTTAA
TTTTTATTTTTATTTTTATTTTTTTGGAATTTTTTTCTTTCAAATATTTT
TAATTTTTAATTTTTATTTTGAGAAACCCTAGATGTTTGAGCCATGGAAA
TAACCCCTACAATTACAACCACCACAGCTACTAACACTGGTAGTACGAAA
TCCACCAGAAGCCGAGAGCGAAACTCCGACAAGGATCCAACCCATTAAGC
CAATCTCCATTAGTAACGGTGTACTCAAACGCCACAACCCACATCACCAC
CATCACCACCACCACCACTTACCGGCGCCGGCCGCAGTATCATCTCCAAC
AGCAGTTGTTTCGTACAGAGAATGTCTCAAAAACCACGCCGCCACTTTGG
GTGGTCATGCCCTAGATGGCTGCGGCGAGTACATGCCTTCACCTACAGCT
ATATCAACAGACCCAACATCGCTAAAATGCGCCGCCTGTGGTTGCCACCG
AAATTATCATCGCCGGGAGCCAGATGAGCAAGCTTTATTGTTACCTCATC
ATCATCATCCAACAACAACAACAACCCATGTCATCGAGTACCAGCCTCAC
CATCGTCACCATCCTCCTCCACCACCTCAGCCACACCACGGCGGTGGAAA
TCGAAGCCCCAATTCGGCTTCTCCTCCGCCGATCTCATCTTCTTACTACC
CATCTGCACCTCACATGCTGTTAGCTCTATCGACCGGGCTATCGGGTCCG
GGCGGAGCCCAAGAGAACGCGGGTGTCGTCGGCGGTGGCGGTGGGATGAT
CACACCGAACTCTAATAGTTCCCGTAAAAGGTTCAGAACTAAGTTCAGTC
AAGAACAGAAAGAGAAGATGTACGAATTCGCTGAGCGAGTTGGTTGGAAG
ATGCAGAAGAGAGATGAAGACATTGTTATGGAGTTTTGTAATGATGTTGG
TGTTGATAAAGGGGTTCTTAAAGTCTGGATGCATAATAACAAGAACACAC
TTGGGAAAAAAGATATTAATGGCGGAGGAGCCAGTACAGGTGGAAGAAGC
AACAACAACAACAACAATACTAATCTTAATCTTCTTGAGCAAAACCATAA
CAATGGCGGTAGCAGCAACAAAACCAACAGTGAGAACGACAACAACAACA
ACAACAATGTTCAGAATCTCAACCATTATAAAGATGATGATGATGATGGT
GGAGTTCATGTAGCAACTAATGGTTCATCTTCTACTTCTTGA